
前言
又是一篇水贴,旨在分享自己写的小程序和分析过程。
分析过程
1.1 URL的构成
以Pixiv博主”可乐米mi”为例,其网址为“https://www.pixiv.net/users/22334948”。当我们看到此url时,其实可以想到大概率组成部分会和后面的数字有关。所以我们便可以再找一个博主的进行比较。接下来是“はねさわ”博主,其网址为“https://www.pixiv.net/users/119532013”。所以现在可以判定,我们的url是由“https://www.pixiv.net/users/+id”所构成的。
1.2 页面分析
当我们打开源代码时,发现所想要保存的图片不在页面当中,并且将鼠标放在想要预览的插画上时,都会有 如图所示的网址,于是,我们可以判断,我们要找的图片URL其实是与这些数字有关的。接下来,我们这里对其做一个简单的抓包,进行分析。
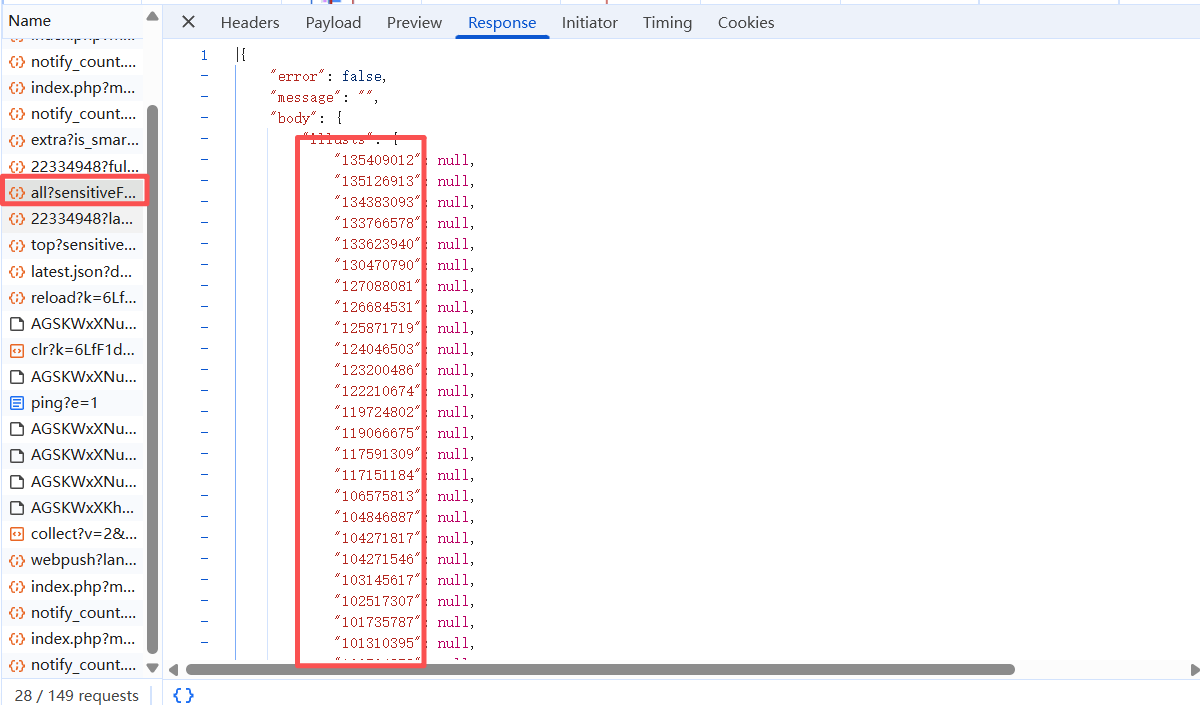
当我们找到此包后,发现所需要的数据都在此中。所以思路就可以是,访问这个包的url来获取json,然后取出这些数字,放在一个列表中,通过遍历列表来取得所有的图片所在地的url。当我们点击一个图片进去后发现面临着同样的问题,预览图片地址也不在url当中。我们打开一个图片在新预览页,发现其URL是“https://i.pximg.net/img-original/img/2025/09/22/18/47/16/135409012_p0.jpg”,所以接下来我们抓包后寻找的应该是神似或者是一样结构的url标题。如图所示
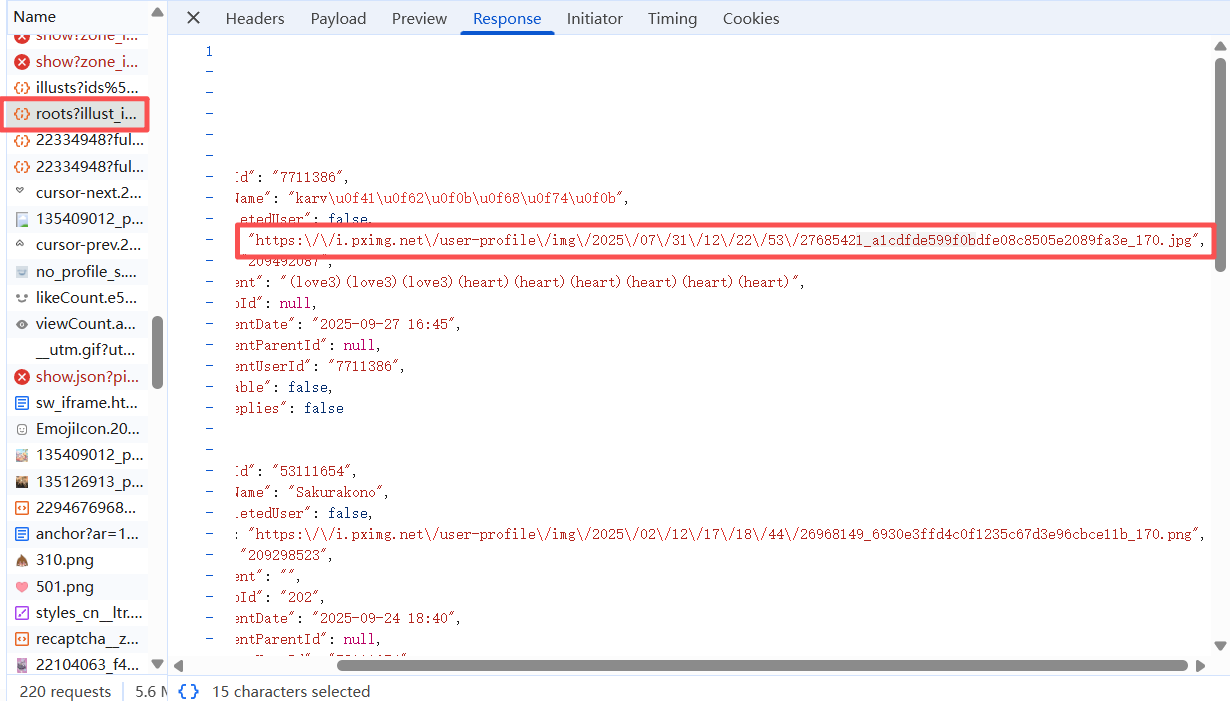
所以我们可以获取所有的json中url的值,然后取第一个,并对他做一些处理,然后得到我们想要的结果。但是这里注意的是,我们需要对它做头的包装,当我们仅仅只是通过网页访问时,并不能获得到其图片,所以当我们对经过PIXIV网站访问的图片预览时,进行抓包发现其有一个防盗链。所以我们要注意这个点。
1.3 思路
- 构造主页面url,使我们进行对其访问获得所有发布图片的帖子;
- 进行抓取其json值,并取出每一个id放到数组中;
- 进行遍历拼接得到我们的子页面url,进行抓取其图片所在的url;
- 保存到本地文件中。
代码实现
import os.path
from urllib.parse import urlparse
import requests
import json
import time
import concurrent.futures
from tqdm import tqdm
from pathlib import Path
import threading
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry
import warnings

# 禁用SSL警告
warnings.filterwarnings('ignore', message='Unverified HTTPS request')


# 判断输入的是否为数字
def judgement_number(id="请输入作者的id:\n"):
    while True:
        user_input = input(id)
        if user_input.isdigit():
            return int(user_input)
        else:
            print("输入无效,请输入id")


def extract_data(number):
    try:
        json_data = json.loads(number)
    except json.JSONDecodeError:
        print("输入的字符串不是有效的JSON格式")
    # 2. 定位到illusts字段(核心目标字段)
    # 按JSON结构逐层获取:body → illusts
    illusts_dict = json_data.get("body", {}).get("illusts", {})
    if not isinstance(illusts_dict, dict):
        raise KeyError("JSON中未找到有效的 'body.illusts' 字段,可能数据格式异常")

    # 3. 提取illusts字典的所有key(即作品ID字符串),并转为数字
    illust_ids = []
    for id_str in illusts_dict.keys():
        # 验证key是否为纯数字(排除可能的非数字异常key)
        if id_str.isdigit():
            illust_ids.append(int(id_str))

    # 4. 去重(避免重复ID)+ 降序排序(符合Pixiv最新作品ID更大的逻辑)
    unique_ids = list(set(illust_ids))
    unique_ids.sort(reverse=True)

    return unique_ids


def extract_pixiv_thumb_urls(full_json_str, target_illust_id=None):
    """
    从Pixiv作品详情JSON中提取缩略图URL(格式:https://i.pximg.net/c/250x250_80_a2/...)
    自动剔除转义字符,返回可直接访问的链接形式

    参数:
        full_json_str: str - 完整的Pixiv作品详情JSON字符串(如你提供的内容)
        target_illust_id: str/int - 可选,指定要提取的作品ID(如135418483),不指定则提取所有有效URL

    返回:
        list - 提取到的缩略图URL列表(可直接复制访问)
    """
    thumb_urls = []

    # 1. 解析JSON数据,自动处理转义字符(JSON.loads会自动处理\转义)
    try:
        json_data = json.loads(full_json_str)
    except json.JSONDecodeError as e:
        raise ValueError(f"JSON解析失败:{str(e)}") from e

    # 2. 定位到存储作品信息的核心字段(userIllusts,包含所有作品的缩略图URL)
    user_illusts = json_data.get("body", {}).get("userIllusts", {})
    if not isinstance(user_illusts, dict):
        raise KeyError("JSON中未找到有效的 'body.userIllusts' 字段,无法提取URL")

    # 3. 遍历所有作品,提取符合格式的缩略图URL
    for illust_id, illust_info in user_illusts.items():
        # 跳过值为null的无效作品
        if not isinstance(illust_info, dict):
            continue

        # 若指定了目标作品ID,只处理该作品
        if target_illust_id is not None:
            if str(illust_id) != str(target_illust_id):
                continue

        # 提取缩略图URL(key为"url",格式正是https://i.pximg.net/c/250x250_80_a2/...)
        thumb_url = illust_info.get("url")
        if not thumb_url or not thumb_url.startswith(
                "https://i.pximg.net/c/250x250_80_a2/"):
            continue  # 只保留目标格式的URL

        # JSON解析后已自动剔除转义字符,直接添加到结果列表
        thumb_urls.append(thumb_url)

    # 去重(避免重复URL)
    unique_thumb_urls = list(set(thumb_urls))
    return unique_thumb_urls


# 全局下载锁,防止重复下载
download_lock = threading.Lock()
downloaded_files = set()


def create_session():
    """创建优化的requests会话"""
    session = requests.Session()

    # 配置重试策略
    retry_strategy = Retry(
        total=3,
        backoff_factor=1,
        status_forcelist=[429, 500, 502, 503, 504],
    )

    adapter = HTTPAdapter(max_retries=retry_strategy)
    session.mount("http://", adapter)
    session.mount("https://", adapter)

    return session


def download_img(image_url, save_dir="Pixiv_Downloads", retry_count=2,
                 sleep_time=0.3):
    """
    优化的图片下载函数

    参数:
        image_url: str - 图片URL
        save_dir: str - 保存目录
        retry_count: int - 下载失败重试次数
        sleep_time: float - 下载前休眠时间(秒)

    返回:
        bool - 下载是否成功
    """
    # 检查是否已经下载过
    with download_lock:
        if image_url in downloaded_files:
            return True
        downloaded_files.add(image_url)

    # 休眠以减少服务器压力
    time.sleep(sleep_time)

    # 确保保存目录存在
    save_dir_path = Path(save_dir)
    save_dir_path.mkdir(parents=True, exist_ok=True)

    # 提取文件名
    parsed_url = urlparse(image_url)
    filename = os.path.basename(parsed_url.path)
    save_path = save_dir_path / filename

    # 检查文件是否已存在
    if save_path.exists():
        print(f"文件已存在,跳过: {filename}")
        return True

    # 请求头
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/139.0.0.0 Safari/537.36",
        "Referer": "https://www.pixiv.net/",
        "Accept": "image/webp,image/apng,image/*,*/*;q=0.8",
        "Accept-Encoding": "gzip, deflate, br",
        "Connection": "keep-alive"
    }

    # 创建会话
    session = create_session()

    # 智能格式检测和下载
    formats_to_try = []
    if filename.lower().endswith('.png'):
        formats_to_try = ['.png', '.jpg', '.jpeg', '.webp']
    elif filename.lower().endswith('.jpg'):
        formats_to_try = ['.jpg', '.jpeg', '.png', '.webp']
    else:
        formats_to_try = [filename.split('.')[-1], '.jpg', '.png', '.webp']

    for format_ext in formats_to_try:
        # 构造URL和文件路径
        base_url = image_url.rsplit('.', 1)[0]
        test_url = f"{base_url}{format_ext}"
        test_filename = filename.rsplit('.', 1)[0] + format_ext
        test_path = save_dir_path / test_filename

        # 检查文件是否已存在
        if test_path.exists():
            print(f"文件已存在,跳过: {test_filename}")
            return True

        try:
            print(f"尝试下载: {test_filename}")
            response = session.get(test_url, headers=headers, timeout=15, verify=False, stream=True)

            if response.status_code == 200:
                # 获取文件总大小
                total_size = int(response.headers.get('content-length', 0))

                # 使用tqdm显示下载进度
                with tqdm(total=total_size, unit='B', unit_scale=True, desc=test_filename, leave=False) as pbar:
                    with open(test_path, "wb") as f:
                        for chunk in response.iter_content(chunk_size=8192):  # 8KB分块
                            if chunk:
                                f.write(chunk)
                                pbar.update(len(chunk))

                # 验证文件完整性
                if total_size > 0 and os.path.getsize(test_path) != total_size:
                    print(f"文件不完整,删除: {test_filename}")
                    os.remove(test_path)
                    continue

                print(f"下载成功: {test_filename}")
                return True

            elif response.status_code == 404:
                print(f"文件不存在: {test_filename}")
                continue
            else:
                print(f"HTTP错误 {response.status_code}: {test_filename}")
                continue

        except Exception as e:
            print(f"下载失败 {test_filename}: {str(e)}")
            if test_path.exists():
                os.remove(test_path)
            continue

    # 所有格式都失败
    print(f"所有格式都下载失败: {filename}")
    return False


def convert_pixiv_thumb_to_original(thumb_url):
    """
    将Pixiv缩略图URL转换为原图URL格式

    输入示例: https://i.pximg.net/c/250x250_80_a2/img-master/img/2025/09/30/19/55/30/135718373_p0_square1200.jpg
    输出示例: https://i.pximg.net/img-original/img/2025/09/30/19/55/30/135718373_p0.png

    参数:
        thumb_url: str - 原始缩略图URL

    返回:
        str - 转换后的原图URL;若格式不匹配则返回None
    """
    # 验证URL格式
    if not thumb_url.startswith("https://i.pximg.net/c/250x250_80_a2/img-master/img/"):
        print("URL格式不匹配,需以'https://i.pximg.net/c/250x250_80_a2/img-master/img/'开头")
        return None

    # 提取路径部分
    base_url = "https://i.pximg.net/"
    path_start = thumb_url.find("img-master/img/") + len("img-master/img/")
    path_part = thumb_url[path_start:]

    # 替换文件名部分
    if "_square1200.jpg" in path_part:
        filename_part = path_part.replace("_square1200.jpg", ".png")
    else:
        print("URL缺少'_square1200.jpg'后缀,无法转换")
        return None

    # 拼接最终URL
    original_url = f"{base_url}img-original/img/{filename_part}"
    return original_url

def download_illust(illust_id, base_headers, base_cookie, user_id, chapter_sleep_time=0.5):
    """
    优化的单个插画作品下载函数

    参数:
        illust_id: int - 插画ID
        base_headers: dict - 基础请求头
        base_cookie: str - Cookie
        user_id: int - 用户ID,用于创建保存目录
        chapter_sleep_time: float - 章节间休眠时间

    返回:
        tuple - (illust_id, success)
    """
    try:
        # 减少休眠时间
        time.sleep(chapter_sleep_time)

        url1 = f"https://www.pixiv.net/artworks/{illust_id}"
        url2 = f"https://www.pixiv.net/ajax/illust/{illust_id}?lang=zh"

        # 构造请求头
        headers = base_headers.copy()
        headers["referer"] = url1
        headers["Cookie"] = base_cookie

        # 使用会话提高效率
        session = create_session()

        print(f"获取作品 {illust_id} 信息...")
        child_resp = session.get(url2, headers=headers, timeout=15)
        child_resp.raise_for_status()

        # 提取缩略图URL并转换为原图URL
        img_urls = extract_pixiv_thumb_urls(child_resp.text)
        if not img_urls:
            print(f"作品 {illust_id} 没有找到有效图片URL")
            return (illust_id, False)

        img_url = img_urls[0]
        orange_img_url = convert_pixiv_thumb_to_original(img_url)

        if not orange_img_url:
            print(f"作品 {illust_id} URL转换失败")
            return (illust_id, False)

        # 下载图片
        save_dir = f"Pixiv_Downloads/{user_id}"
        success = download_img(orange_img_url, save_dir=save_dir)
        return (illust_id, success)

    except Exception as e:
        print(f"处理作品 {illust_id} 时出错: {str(e)}")
        return (illust_id, False)

def main():
    """
    优化的主函数,协调整个下载流程
    """
    # 获取用户输入
    user_id = judgement_number()

    # 优化的参数设置
    max_workers = 8  # 增加线程数
    chapter_sleep_time = 0.3  # 减少休眠时间

    # 构造请求URL和头信息
    url = f"https://www.pixiv.net/ajax/user/{user_id}/profile/all?sensitiveFilterMode=userSetting&lang=zh"
    cookie = "first_visit_datetime_pc=2025-08-15%2018%3A15%3A33; yuid_b=E2c2kCM; p_ab_id=8; p_ab_id_2=8; p_ab_d_id=1137085753; _ga=GA1.1.873451282.1755249361; privacy_policy_agreement=7; c_type=21; privacy_policy_notification=0; a_type=0; b_type=1; __utmz=235335808.1755249613.1.1.utmcsr=accounts.google.com|utmccn=(referral)|utmcmd=referral|utmcct=/; __utmv=235335808.|3=plan=normal=1; _gcl_au=1.1.1091546944.1756888925; _im_vid=01K47BZ2WV9Z7S12FN628YZPXM; device_token=36f5bac981cf92b38c7259aa3b608ac5; PHPSESSID=120007205_DfWy7ydXBvRNvApY8Xj1m4oEgqGKOSMB; _ga_MZ1NL4PHH0=GS2.1.s1758182813$o2$g1$t1758183217$j49$l0$h0; _cfuvid=YKCSHYcrAsFcAcoYkkb_ukM9A0VBLr.kP7s7ezAI.ZA-1759550649835-0.0.1.1-604800000; __utma=235335808.873451282.1755249361.1755249613.1759550650.2; __utmc=235335808; cto_bundle=pgH9_F9QVUdrUDlzMUZDNERrS2hIdnB5JTJCRDY5eGJmT2tlZzBkQUZsejBtdlltdGx2a3p0a1JhJTJCZiUyQmx6N0NRQSUyRjhIYmdPS2RqSVJSM1FKUXJoUFBNUDVpcklxZ0hKNCUyQklrUkZISjVBNkxGeUhEZTlmMFMxRHklMkZKODUlMkZ5YldVNHVYU1dsdWVyQmZQR2NBUCUyQk9Ud1FYdER3RXN3JTNEJTNE; __cf_bm=ZxRXeYD4V2OZWT407ZzbKp37ZDORpMpz4h8ygmxzERA-1759552464-1.0.1.1-X6JKyG6UfA7ehNfuLgkZ61om_71aSacnlGc0ln0.vV5ZWVVJeigt_BkpvW06IlIBNnrZlTIRClbVZ_JoL9GW7RfyO30KXgv3ip_TBVPtrgmk5wVJtH3.fHauZmvjRnfE; FCNEC=%5B%5B%22AKsRol-WH-CnIB1lF3pYT8dUmZAviwaUGOjnc3CpMj7Yap___w_M-Zij9tFpbtyb4MgcqZZfTl-AT3qfivIJhyd-6mH5yaeqbAG-qFgEL-QFpe_VwRdWi8-DDLOPq6MF5pcXp_3FJDhnKRgTW844sLUiLhb-IMvMDA%3D%3D%22%5D%5D; _ga_75BBYNYN9J=GS2.1.s1759550651$o8$g1$t1759553667$j60$l0$h0; cf_clearance=0Lk0PSp3zmAAbpmU5W7oYtjQ4pZk0PK4.pC70jW7_ss-1759553672-1.2.1.1-4yMS3tAaUUjVbj6e6iphz5CZd5cF6lAHWoLlINAAIpx6.rIYI2ntd03SASEfsoxPwf7_RyffRP_ZaObp3JO17KMMe4sOVISrdNymlE6Fk0wn1TmnoLFtiejUq0lx1FWT2LOuEBBWVJTn7G2u3ZhlEo36VNV4OKNEFw58Ga.4b6zfweRLK4PF731eHpW3MrNy2.5VqG.lfdzm..v9EXb6dYUzg5dV.7IeBuRR1N1KvSs; __utmt=1; __utmb=235335808.32.10.1759550650"

    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/139.0.0.0 Safari/537.36",
        "referer": f"https://www.pixiv.net/users/{user_id}",
        "Accept": "application/json, text/plain, */*",
        "Accept-Language": "zh-CN,zh;q=0.9,en;q=0.8",
        "Cookie": cookie
    }

    try:
        # 获取用户作品ID列表
        print(f"正在获取作者 {user_id} 的作品列表...")
        session = create_session()
        resp = session.get(url, headers=headers, timeout=15)
        resp.raise_for_status()

        illust_ids = extract_data(resp.text)
        print(f"成功获取到 {len(illust_ids)} 个作品")

        if not illust_ids:
            print("未找到作品,程序结束")
            return

        # 检查已下载的文件,过滤掉已存在的作品
        save_dir = Path(f"Pixiv_Downloads/{user_id}")
        if save_dir.exists():
            existing_files = {f.stem.split('_')[0] for f in save_dir.glob('*') if f.is_file()}
            illust_ids = [id for id in illust_ids if str(id) not in existing_files]
            print(f"过滤已下载作品后,剩余 {len(illust_ids)} 个作品需要下载")

        if not illust_ids:
            print("所有作品都已下载完成!")
            return

        # 使用线程池并发下载
        success_count = 0
        fail_count = 0

        print(f"\n开始下载作品(使用 {max_workers} 个线程)...")

        with concurrent.futures.ThreadPoolExecutor(max_workers=max_workers) as executor:
            # 提交所有任务
            future_to_illust = {
                executor.submit(download_illust, illust_id, headers, cookie, user_id, chapter_sleep_time): illust_id
                for illust_id in illust_ids
            }

            # 使用tqdm显示整体进度
            with tqdm(total=len(illust_ids), desc="总体进度", unit="作品") as pbar:
                # 处理完成的任务
                for future in concurrent.futures.as_completed(future_to_illust):
                    illust_id, success = future.result()

                    if success:
                        success_count += 1
                    else:
                        fail_count += 1

                    pbar.update(1)
                    pbar.set_postfix({
                        '成功': success_count,
                        '失败': fail_count,
                        '成功率': f"{success_count/(success_count+fail_count)*100:.1f}%"
                    })

        # 显示下载统计
        print("\n下载完成!")
        print(f"总计: {len(illust_ids)}, 成功: {success_count}, 失败: {fail_count}")
        if success_count + fail_count > 0:
            print(f"成功率: {success_count/(success_count+fail_count)*100:.1f}%")

    except Exception as e:
        print(f"程序运行出错: {str(e)}")

if __name__ == "__main__":
    main()

评论(0)
暂无评论