
引言
在我们的生活中会遇到很多的数据,或者是自己想看的照片,或者是电影评分,一些商品比较。这个时候,如果我们手动收集需要消耗很多的时间,精力。此时爬虫就在数据收集、分析中体现了其使用价值。而本文则简要的叙述关于爬虫的相关知识。
一、爬虫入门:核心库与基础原理
1.1 基础工具的了解
对于爬虫,如同网络安全和网络工程一样,抓包是一项必不可少的工作,但是我们没有类似网络安全那样使用 BP 或者是网络工程那般使用 wireshark,通常情况下利用浏览器自带的抓包即可(这里推荐使用 google 或者是微软)接下来便会介绍一下工具的使用,首先打开 F12
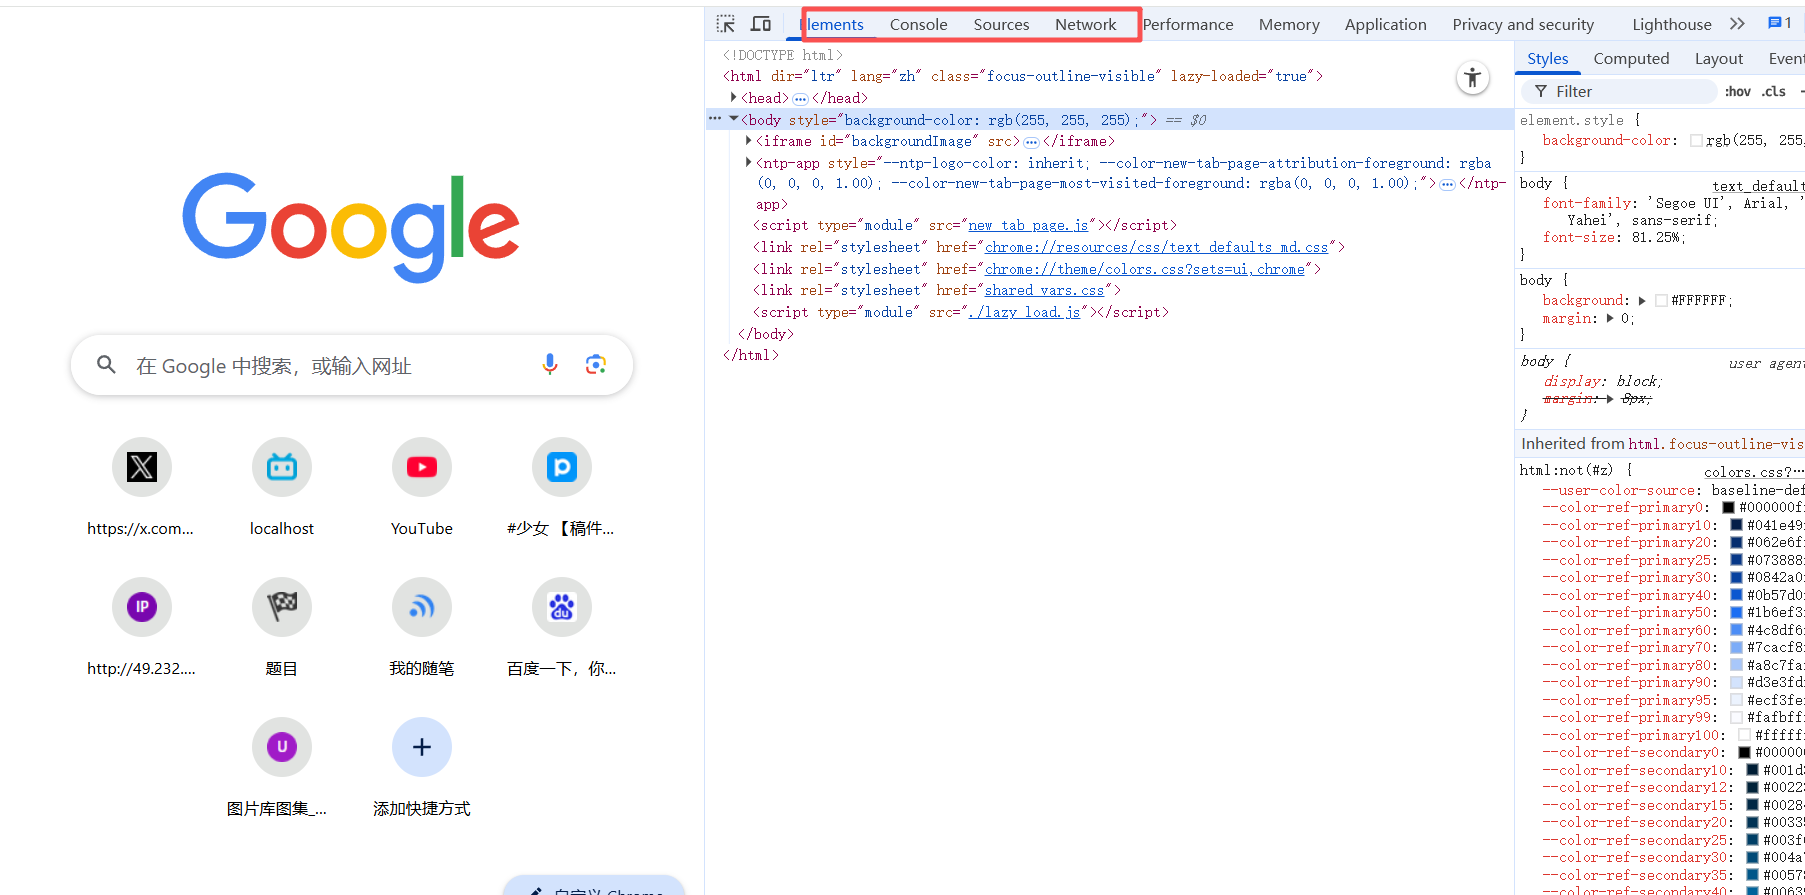
如图中圈出的所示,我们主要使用的是 Elements、Console、Sources以及 Network 。
对于 Elements 大家会误认为是源代码,实则不然,如果想查看源代码,则应该使用鼠标右键的检查代码。如图所示:
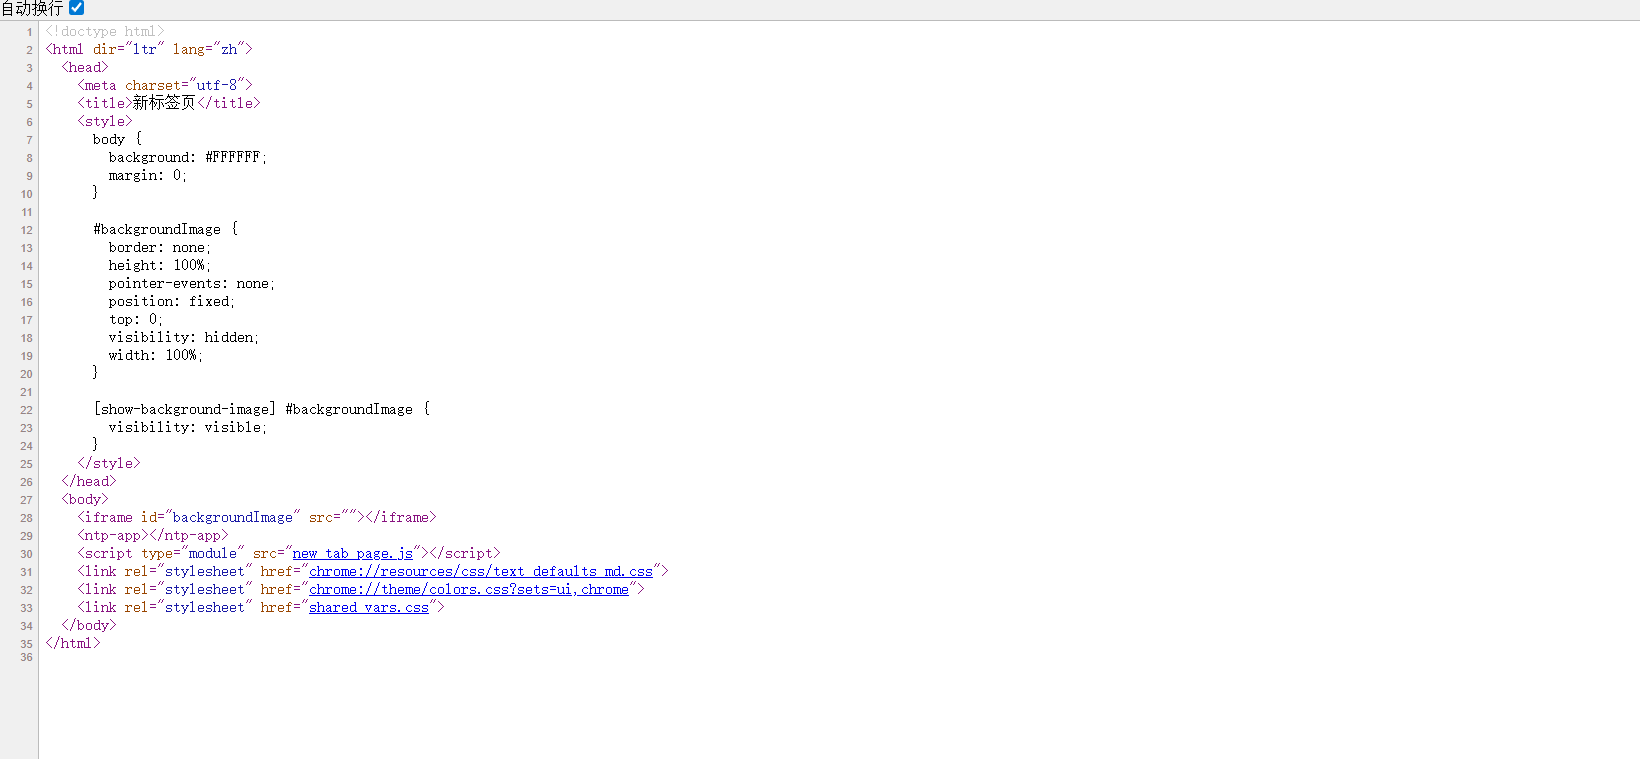
那就有人会问:这两个有什么区别呢?拿考试举例子来说,查看源代码,相当于老师给出的卷子的标准答案;而 Elements 是由学霸自己写出的不是很简洁的答案。可是,那是不是意味着 Elements 是没有用的呢?答案是错误的,在一个只有代码的页面里,我们想要找到我们所需要的标签是困难的,有时候便会须有借助 Elements 去定位我们所需要的标签。
console 是一个用来调试 JavaScript 的工作台,在爬虫中用处不是很大。下文如有需要会单独去说。
Sources 是存放了源代码的文件夹可以查看其文件。
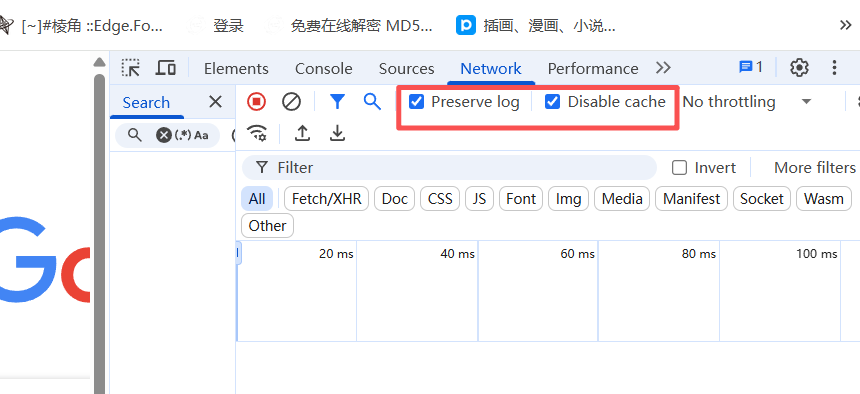
Network 则是我们用的最多的,要注意打开这些选项,当刷新后会出现所有传输的数据包,有时候我们想要的便在这里。
1.2 基础库 urllib
引入库 urllib.request 。即
from urllib.request import urlopen接下来以百度为例,在 urllib 库中引用 urlopen 方法:
url = "http://www.baidu.com"  # 定义要访问的url

resp = urlopen(url)  # 打开url
#print(resp.read().decode("utf-8"))  # 读取响应内容并解码为utf-8,此时拿到的是源代码

with open("mybaidu.html",mode="w",encoding="utf-8") as f:   # 打开文件,指定编码为utf-8
    f.write(resp.read().decode("utf-8"))  # 写入文件
首先我们需要给出一个 url ,告诉爬虫我们要去哪里爬,所以这个时候就要利用 urlopen() 方法进行获取 url 。
而 resp.read() 获取的其实是字节,所以需要通过解码的形式,获取到我们能看懂的源代码。但是解码的码源对于不同网站是不一样的,所以此时需要用 CTRL+F 搜索“charset”这个单词来查找发现使用的码源,百度用的是“UTF-8”.如图:
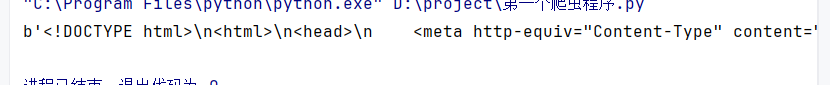
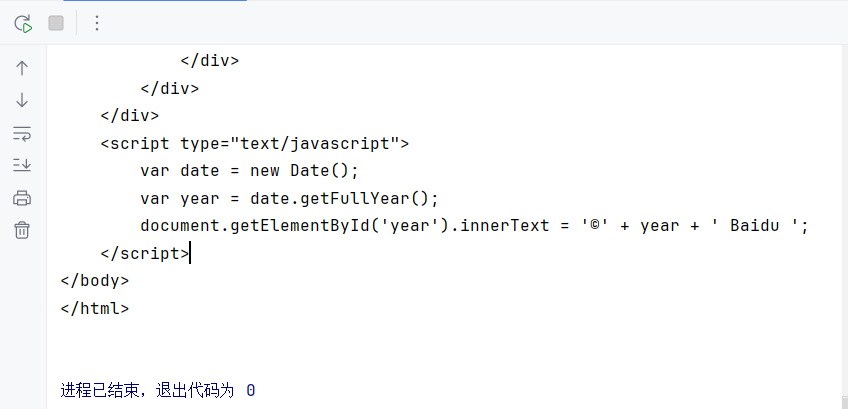
图一是未使用解码的效果,图二是使用了解码的效果。
到这里我们并没有将其保存,所以为了将其保存,我们使用了函数即“with open() as”
python 文件读写,以后就用 with open 语句。
with open("filename.txt",'r') as f:
	content = f.read(f)   #文件的读操作
其中意思为保存文件类型为txt,以只读的方式打开文件。
with open("data.txt","w") as f:
    content = f.write("hello world")   #文件的写操作
其中意思为保存文件类型为txt,以只用于写入的方式打开文件
故,对于我们想要保存的源代码,则需要用到如此语句
with open("mybaidu.html",mode="w",encoding="utf-8") as f:
    f.write(resp.read().decode("utf-8"))
该代码段的意思是,将url的页面用 utf-8 的形式解码写入到 mybaidu.html 中并保存。
但是需要注意的是:urllib.requests 库是自带的,并不好用,所以引入新的库 requests 。该库需要下载,在终端输入 pip install requests 进行下载。下载完成后便可正常使用。
import requests

url = "http://www.baidu.com"

resp = requests.get(url)  #发送get请求体
resp.encoding = "utf-8"
print(resp.txt)  #拿到页面源代码
1.3 POST 与 GET 请求
1.3.1 POST 请求
以百度翻译为例
import requests

url = "https://fanyi.baidu.com/sug"   #对于post无论url有多长都需要拿过来

data ={
    "kw":input("请输入一个单词:")
}

rep = requests.post(url,data=data)   #data为post请求的数据包参数

print(rep.text)   #拿到的是文本字符串
print(rep.json()['data'])  #此时拿到的直接是json数据
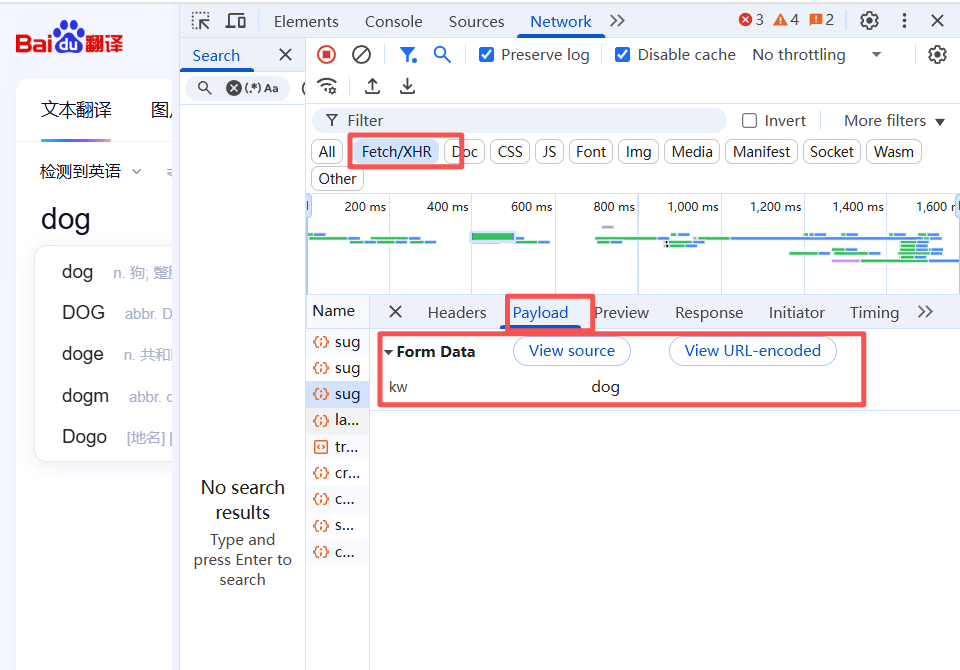
对于data部分,有人可能会问,这是在哪里呢?我们在百度翻译里输入dog(最后使用中文输入)
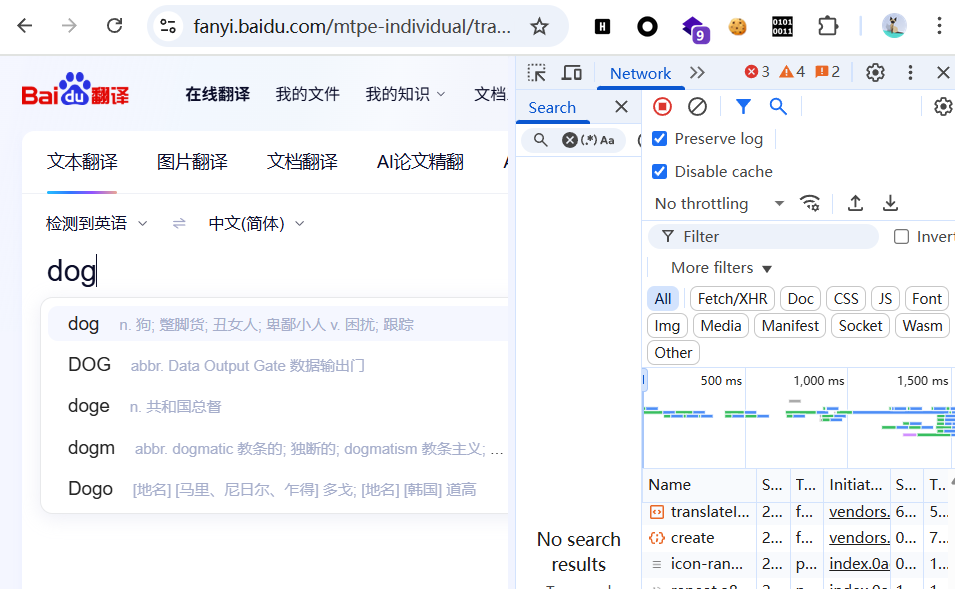
抓包后,我们可以在form data中找到相应的数据,如下图所示:
1.3.2 GET 请求
以豆瓣为例
import requests

#get请求只需要提取问号前面的url
url = "https://movie.douban.com/j/chart/top_list"

data = {
    "type":"13",
	"interval_id":"100:90",
	"action":"",
	"start" :"0",
	"limit":"20"
}

header = {
    "user-agent":"Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/139.0.0.0 Safari/537.36"
}

resp = requests.get(url,params=data,headers=headers)   #处理get请求数据包为params

print(resp.text)
print(resp.request.url)   #查看url
对于data部分,在Get请求中为Query String Parameters,与POST请求在同一个位置,需要注意的是GET请求只需要提取问号前面的URL,而非整个的URL。
二、网页解析:从 HTML 中提取数据
2.1 HTML 与 CSS
2.1.1 HTML 基础语法
<!DOCTYPE html>
<html lang="en">
<head>
    <meta charset="UTF-8">
    <title>标题</title>
</head>
<body>

</body>
</html>

<!--
html基本语法:
1.<标签名 属性="属性值">被标记的内容</标签名>
2.<标签名 属性="属性值" />
2.1.2 CSS 基础语法
完整的 CSS 代码由 “选择器” 和 “声明块” 组成,但爬虫场景下,我们只需要 “选择器”
| 需求场景 | 推荐选择器 | 示例 |
|---|---|---|
| 定位唯一元素 | ID 选择器(#id) | #user-avatar → 定位用户头像 |
| 定位一类元素(如商品列表) | 类选择器(.class) | .goods-item → 定位所有商品项 |
| 定位嵌套元素(如列表里的链接) | 后代选择器(空格) | .goods-list a → 定位商品列表里的所有链接 |
| 定位带特定属性的元素(如图片) | 属性选择器([属性]) | img[src] → 定位所有图片(带 src 属性的 img 标签) |

评论(0)
暂无评论